Google ouvre DiffusionGemma, un modèle de langage qui génère le texte comme une image se débruite
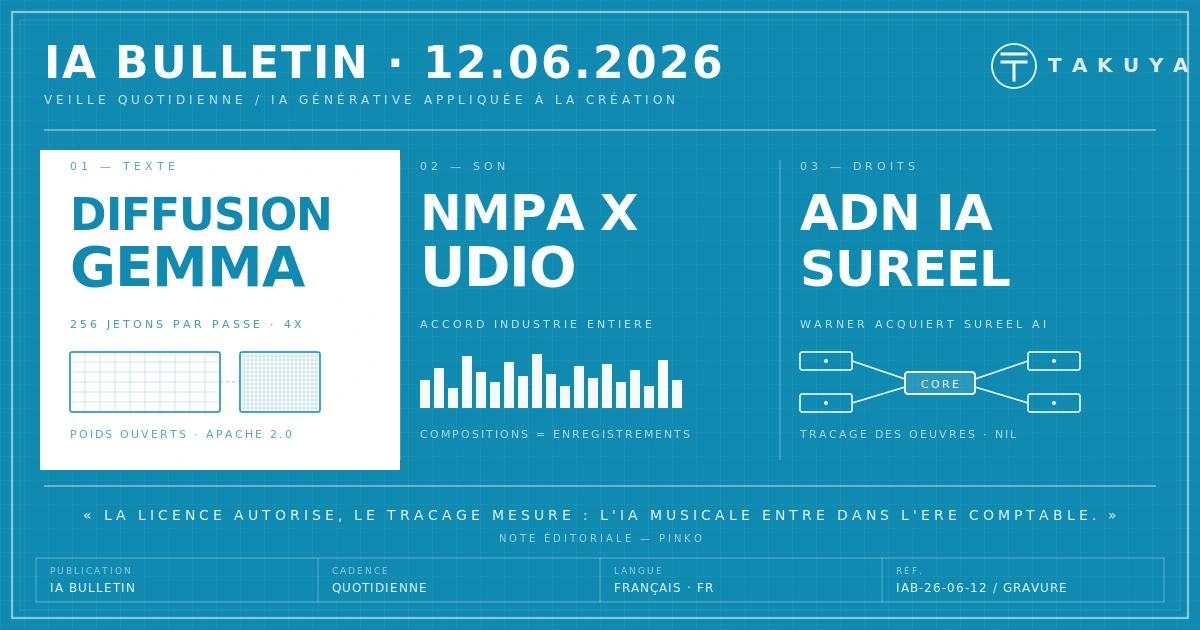
Google DeepMind a publié le 10 juin DiffusionGemma 26B-A4B, un modèle de langage expérimental en poids ouverts (licence Apache 2.0) qui abandonne la génération mot à mot au profit de la diffusion discrète. Comme un générateur d'images part d'un bruit aléatoire pour faire émerger une image, le modèle part d'un bloc de 256 jetons placeholders et le raffine en plusieurs passes de débruitage jusqu'à obtenir un texte lisible. Le procédé génère jusqu'à quatre fois plus vite qu'un modèle classique — plus de 1 000 jetons par seconde sur une seule carte H100 — et l'architecture MoE de 26 milliards de paramètres n'en active que 3,8 milliards à la fois. Le modèle accepte texte, image et vidéo en entrée, couvre plus de 140 langues avec une fenêtre de 256 000 jetons, mais reste en deçà de Gemma 4 sur les benchmarks de qualité comme MMLU. Google assume le statut expérimental de la sortie, pensée pour les chercheurs et les configurations modestes : la sobriété mémoire du modèle lui permet de tourner sur des cartes graphiques grand public haut de gamme.
Voir la diffusion — née dans l'image — coloniser le texte dit quelque chose de la convergence des ateliers : les mêmes mathématiques débruitent désormais un paragraphe et un visuel. Et la vitesse n'est pas un confort d'ingénieur — à 1 000 jetons par seconde, l'esquisse écrite redevient un geste d'itération, pas une attente.