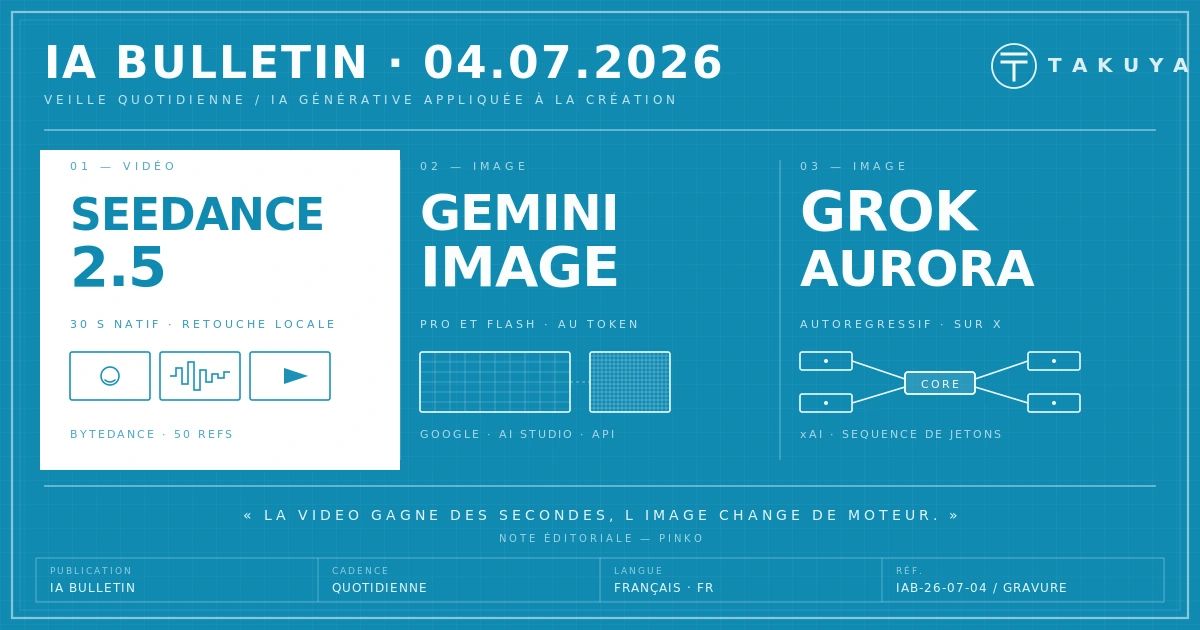
IA Bulletin — 4 juillet 2026

Seedance 2.5 et la vidéo IA de trente secondes /
Le dédoublement de Gemini Image chez Google /
Aurora, l'image autorégressive branchée dans Grok

Seedance 2.5 ouvre au public la vidéo IA de trente secondes

ByteDance a ouvert au public Seedance 2.5, son modèle de génération vidéo, après une phase d'accès réservé aux entreprises annoncée le 23 juin. La bascule majeure tient à la durée : le modèle produit trente secondes en une seule passe, sans assemblage de fragments, là où la plupart des concurrents plafonnent autour de dix. Seedance accepte jusqu'à cinquante références multimodales — images, sons, plans — pour tenir un personnage, une marque et un style sur toute la durée du plan. Sa retouche locale permet de corriger un détail, une couleur de cheveux ou un objet, sans régénérer le clip entier, ce qui déplace le travail vers la révision plutôt que le tirage. L'architecture co-traite l'image et le son dans un même espace latent, gage de synchronisation, mais le texte à l'écran et les scènes très longues restent des points fragiles.

Note éditoriale

Trente secondes d'un seul tenant, ce n'est pas un record de foire : c'est le seuil où un plan cesse d'être une vignette pour devenir une séquence qu'on peut monter. La retouche locale compte davantage encore, car elle sauve la prise réussie au lieu de rejouer la loterie complète. Reste la limite connue de la durée : la continuité tient mieux, mais elle se paie en contrôle, et un studio avisé teste la tenue d'un personnage sur vingt plans avant d'y confier une commande.
Sources : The Decoder — Seedance 2.5 franchit la barre des trente secondes — Tech Times — Seedance 2.5, trente secondes natives sans assemblage

Google dédouble Gemini Image en une version Pro et une version Flash

Google a publié deux modèles d'image distincts : Gemini 3 Pro Image, orienté fidélité, et Gemini 3.1 Flash Image, taillé pour le volume et le coût. Le premier vise la production créative exigeante, du design à la campagne, quand le second privilégie la vitesse pour les usages à fort débit où l'on peut céder un peu de qualité. La facturation, désormais au token comme pour un modèle de langage, sépare nettement les deux gammes : la version Flash démarre à un demi-dollar le million de tokens en entrée, la version Pro grimpe à quatre fois plus. Les deux sont accessibles immédiatement via Google AI Studio et l'API Gemini, sans liste d'attente. Cette segmentation par usage plutôt que par génération technique installe un choix explicite, jusque dans un travail précis comme concevoir la pochette d'un album, entre rendu soigné et cadence de production.

Note éditoriale

Dédoubler la gamme en Pro et Flash, c'est admettre qu'il n'existe pas un seul régime de génération d'image : il y a le tirage final qu'on soigne et le brouillon qu'on multiplie. Le studio y gagne de la clarté à condition de savoir, avant de lancer, dans lequel des deux il travaille. La facturation au token rapproche l'image du coût d'itération des grands modèles de langage — utile pour budgéter, sournois pour qui laisse tourner sans compter.

Sources : LLM Stats — mises à jour des modèles, juillet 2026 — Google AI — génération d'image avec l'API Gemini

xAI branche le modèle autorégressif Aurora dans Grok

xAI a mis à jour Grok avec Aurora, un modèle de génération d'image directement accessible depuis la plateforme X. Aurora délaisse la diffusion pour une approche autorégressive : l'image se construit par prédiction séquentielle, à la manière d'un modèle de langage qui pose ses jetons l'un après l'autre. Cette architecture, que Luma a récemment portée avec Uni-1, promet une meilleure prise en compte du texte et des consignes composées, au prix d'un rendu qui se joue dans l'enchaînement plutôt que dans le débruitage global. L'intégration à X place la génération d'image au cœur d'un réseau social de masse, ce qui déplace la question du studio vers celle de la diffusion et de la modération. Pour un directeur artistique, l'intérêt tient moins à l'effet de nouveauté qu'à la convergence : plusieurs laboratoires misent désormais sur l'autorégressif pour l'image, signe qu'une bascule d'architecture est en cours.

Note éditoriale

Quand deux laboratoires indépendants abandonnent la diffusion pour l'autorégressif la même saison, ce n'est plus une lubie d'architecte, c'est une tendance de fond. Un modèle qui planifie sa composition avant de la rendre sert la précision là où le débruitage se contentait de textures flatteuses. Reste que loger un générateur d'image dans un réseau social de masse règle un problème de distribution et en ouvre un autre, celui du volume et de sa modération, qui n'a rien à voir avec la qualité du rendu.

Sources : xAI — actualités produit et recherche — LLM Stats — actualités des modèles, juillet 2026
Post — Studio Takuya