IA Bulletin — 16 juillet 2026

L'image par calques au sommet de l'Arena /
Des preuves d'entraînement en litige chez OpenAI /
Un carnet de notes sévère pour les labs

Reve 2.1 fait de chaque élément d'image un calque éditable

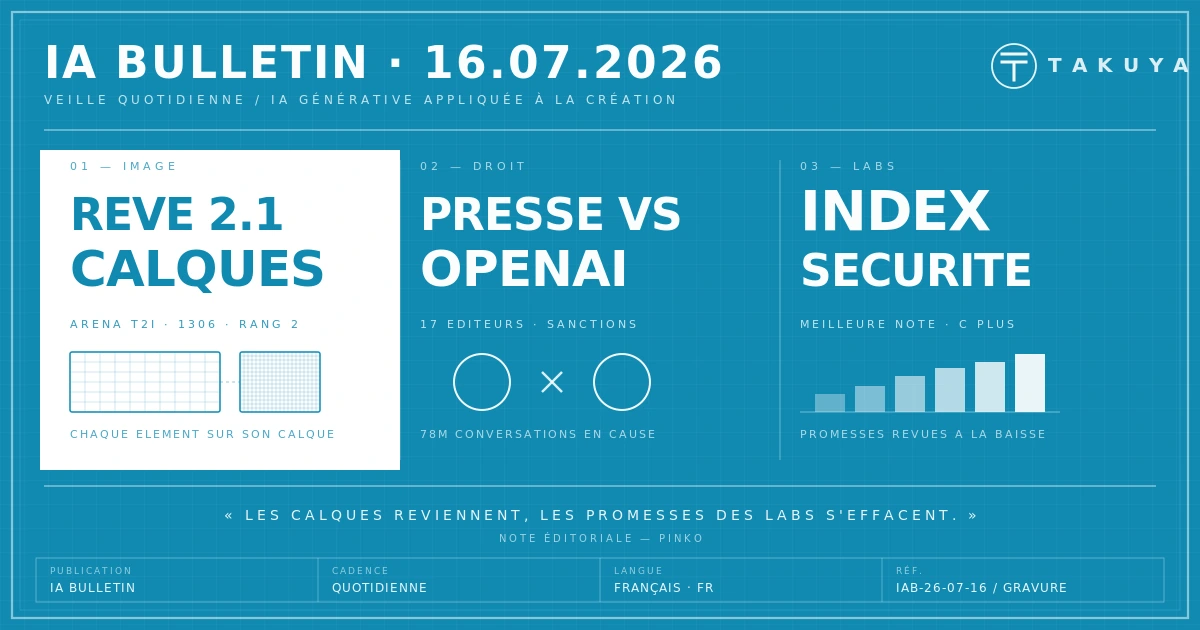
Publié le 9 juillet, un mois seulement après Reve 2.0, Reve 2.1 s'installe au deuxième rang de l'Arena texte-image avec un score de 1306 points, à 28 points du reste du peloton, délogeant Muse Image de Meta qui n'aura tenu la place qu'une trentaine d'heures. Sa singularité est architecturale : un moteur de mise en page construit l'image élément par élément, chaque objet vivant sur son propre calque éditable. Modifier un élément ne régénère pas tout le visuel — l'image se recompose autour de la retouche, là où la concurrence repart de zéro ou presque. Le modèle se classe aussi huitième en édition mono-image, au niveau de Nano Banana Pro, avec une meilleure compréhension des prompts et un rendu plus fiable des textes en langues étrangères. Ce retour du calque, vocabulaire natif des graphistes, rapproche la génération d'image des usages concrets des studios, de la maquette d'affiche à la composition graphique d'une pochette d'album.

Note éditoriale

Les calques n'ont jamais quitté Photoshop ; c'est la génération qui les avait fait disparaître. Leur retour dans un modèle de pointe dit quelque chose de la maturité du secteur : après la course au photoréalisme, les outils réapprennent la structure réelle du travail graphique. En production, un visuel qui se corrige élément par élément vaut plus qu'un visuel légèrement plus beau qu'il faut regénérer en entier.
Sources : Reve — annonce de Reve 2.1 — ThursdAI — July 2026 AI Releases — Arena — classement texte-image

Dix-sept éditeurs de presse demandent des sanctions contre OpenAI

Le New York Times, le Daily News et quinze autres éditeurs ont déposé devant un tribunal fédéral de Manhattan une motion de sanctions contre OpenAI dans leur procès pour violation du droit d'auteur. Ils accusent l'entreprise d'avoir affirmé au tribunal qu'elle ne pouvait pas rechercher les œuvres protégées dans ses systèmes, alors qu'elle avait mené exactement ces recherches en interne avant l'ouverture des poursuites. Une déposition d'avril a révélé l'existence d'une base de 78 millions de conversations ChatGPT dé-identifiées, utilisée par OpenAI pour mesurer elle-même l'ampleur des reproductions d'articles. Les éditeurs soutiennent en outre que des milliards d'échanges ont été rendus inaccessibles, par suppression ou par retrait des index de recherche. OpenAI dément et invoque la protection de la vie privée de ses utilisateurs, mais l'enjeu dépasse la presse : le standard de divulgation qui sortira de ce dossier s'appliquera demain aux images comme à la musique.

Note éditoriale

La question n'est plus seulement de savoir si l'entraînement sur des œuvres protégées est légal, mais si les laboratoires peuvent être contraints de montrer ce qu'ils ont fait. Une sanction pour dissimulation pèserait plus lourd qu'un jugement au fond : elle fixerait le niveau de transparence exigible de toute l'industrie. Les ayants droit de la musique et de l'image suivent ce dossier de presse écrite comme s'il était le leur — et il l'est.

Sources : TechCrunch — New York Times says OpenAI hid evidence in ChatGPT copyright trial — TheWrap — Publishers accuse OpenAI of obstructing evidence

Le Future of Life Institute note les labs, aucun ne dépasse C+

Le Future of Life Institute a publié le 15 juillet son AI Safety Index 2026, évaluation indépendante des grands laboratoires d'intelligence artificielle. La meilleure note est un simple C+, attribué à Anthropic, devant OpenAI et Google DeepMind notés C, Meta à D+, tandis que xAI, DeepSeek et Mistral échouent à l'évaluation. L'index mesure la gestion des risques, la transparence, la gouvernance et le respect par chaque laboratoire de ses propres engagements de sécurité. Le constat central est que plusieurs acteurs majeurs ont discrètement révisé à la baisse des promesses formulées au moment de leurs levées de fonds. Pour les créatifs qui bâtissent leurs workflows sur Gemini, Muse ou GPT, la colonne gouvernance mérite désormais d'être lue à côté de la colonne benchmark.

Note éditoriale

Un C+ en tête de classe n'est pas un satisfecit, c'est un constat d'insuffisance générale. La valeur de ces index tient à leur mémoire : consigner les promesses au moment des levées de fonds, puis mesurer ce qu'il en reste une fois les produits livrés. Les benchmarks disent ce que les modèles savent faire ; ces notes disent ce que l'on peut attendre de ceux qui les fabriquent.

Sources : Future of Life Institute — AI Safety Index — Build Fast with AI — AI News July 15, 2026
Annales — Studio Takuya