IA Bulletin — 31 juillet 2026

La tarification façon Chine chez OpenAI /
La génération d'images au régime GPU /
Cent milliards pour la donnée spécialisée

OpenAI casse les prix de GPT-5.6 Luna de 80 %

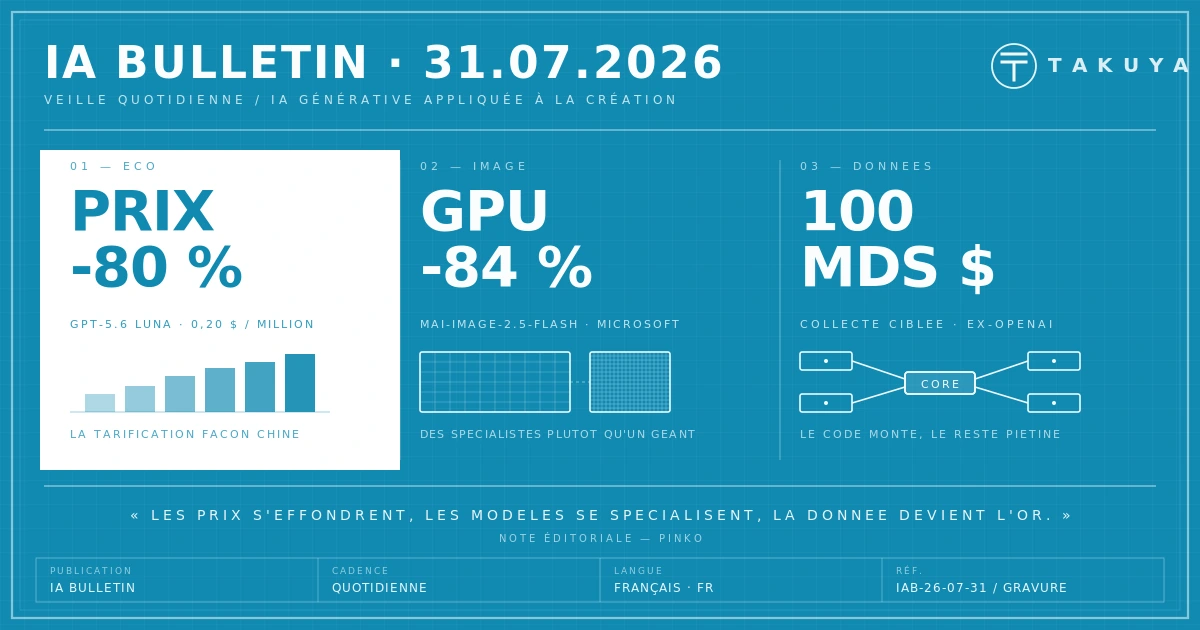
OpenAI a abaissé jeudi de 80 % le tarif de GPT-5.6 Luna, son modèle le plus abordable, désormais facturé 0,20 dollar le million de tokens en entrée et 1,20 dollar en sortie, tandis que Terra baisse de 20 % et que Sol ne bouge pas. La société affirme que Luna égale les performances des meilleurs modèles d'il y a un an : une tâche qui coûtait alors un dollar revient aujourd'hui à environ 6 cents, près de neuf fois plus vite. La baisse serait financée par les gains d'infrastructure obtenus par GPT-5.6 Sol lui-même, qui aurait optimisé de son propre chef le logiciel GPU de la maison — 20 % de coûts de déploiement en moins et 15 % de génération de tokens en plus via le décodage spéculatif. La pression des fournisseurs chinois à bas coût, et un Microsoft qui promeut ouvertement ses modèles MAI comme alternatives économiques, pèsent visiblement sur la manœuvre. Pour les pratiques créatives branchées sur l'API — variations de textes, chaînes de génération d'images, pipelines vidéo — la facture mensuelle vient de changer d'ordre de grandeur.

Note éditoriale

La « tarification façon Chine » n'est pas un geste commercial, c'est un aveu : l'intelligence brute est devenue une commodité qui se négocie au centime le million de tokens. Le détail le plus vertigineux tient dans la méthode — un modèle qui optimise lui-même l'infrastructure qui le fait tourner, et finance ainsi sa propre baisse de prix. Quand l'outil ne coûte presque plus rien, la valeur migre ailleurs : vers le regard qui sait quoi lui demander.
Sources : The Decoder — OpenAI goes full China pricing mode — OpenAI — Advancing the price-performance frontier

Microsoft met la génération d'images au régime GPU

Mustafa Suleyman, patron de Microsoft AI, a détaillé mercredi la nouvelle doctrine maison : plutôt qu'un modèle frontière universel, des modèles spécialistes compacts entraînés chacun pour un seul domaine. Le générateur MAI-Image-2.5-Flash réduirait ainsi les coûts GPU jusqu'à 84 % par rapport à GPT-Image-2, et le modèle de cybersécurité MAI-Cyber-1-Flash dépasserait le Mythos d'Anthropic de 12 points sur CyberGym pour moitié moins cher. Le résultat repose toutefois sur MDASH, un orchestrateur qui répartit les tâches entre plusieurs modèles et renvoie encore les cas difficiles vers les modèles de raisonnement d'OpenAI. La compétition se déplace du modèle vers le harnais — le logiciel qui route les requêtes et fournit le contexte —, une approche que pratiquent déjà Anthropic avec Fable 5 et Sakana avec Fugu. Pour un atelier graphique, l'équation est directe : une image cinq fois moins chère à produire, c'est une phase d'exploration qui s'élargit d'autant, des dizaines de pistes esquissées avant d'engager l'enveloppe graphique d'un album dans sa version définitive.

Note éditoriale

Après la course à la taille, la course à l'économie — le marché découvre que le prix d'une image n'a jamais été celui du modèle mais celui du GPU qui tourne derrière. La bascule vers les orchestrateurs déplace la question intéressante : demain, le choix du modèle sera aussi invisible que celui du serveur qui héberge une page. Reste à vérifier ce que ces 84 % d'économies retranchent en finesse de rendu, car le benchmark ne mesure jamais l'œil.

Sources : The Decoder — Microsoft AI bets on cheap specialist models — Microsoft AI — Optimizing the frontier performance curve

Cent milliards de dollars vers la donnée d'entraînement spécialisée

Andrew Ho, ancien d'OpenAI, et le chercheur de Cambridge Adam Hunt pointent une dérive des grands modèles de langage : au lieu de gagner en polyvalence, ils se spécialisent. Excellents en code et en mathématiques — là où la donnée d'entraînement abonde et se vérifie automatiquement —, ils stagneraient voire régresseraient dans les autres domaines. Ho quitte OpenAI pour fonder une société dédiée à la donnée d'entraînement spécialisée, et prédit que les laboratoires devront investir plus de 100 milliards de dollars dans la collecte ciblée. Le raisonnement tient en une ligne : le passage à l'échelle seul ne suffit plus, c'est la qualité et la spécificité du corpus qui font désormais la différence. Les domaines créatifs — écriture, composition, direction artistique — figurent précisément parmi ces territoires où la donnée vérifiable manque et où les modèles piétinent.

Note éditoriale

L'aveu vaut son pesant de tokens : après avoir siphonné le web entier, les laboratoires découvrent que la matière première manque — non en volume, mais en précision. La spécialisation code-maths des modèles n'est pas un choix d'ingénierie, c'est le reflet des seules données qui se vérifient toutes seules. Pour les pratiques créatives, la conséquence est double : des outils qui plafonnent, et une donnée artistique de qualité qui devient soudain un actif négociable.

Sources : The Decoder — Ex-OpenAI researcher bets $100 billion will flow into training data
DA — Studio Takuya
DA — Studio Takuya