Les vidéos de crise indétectables
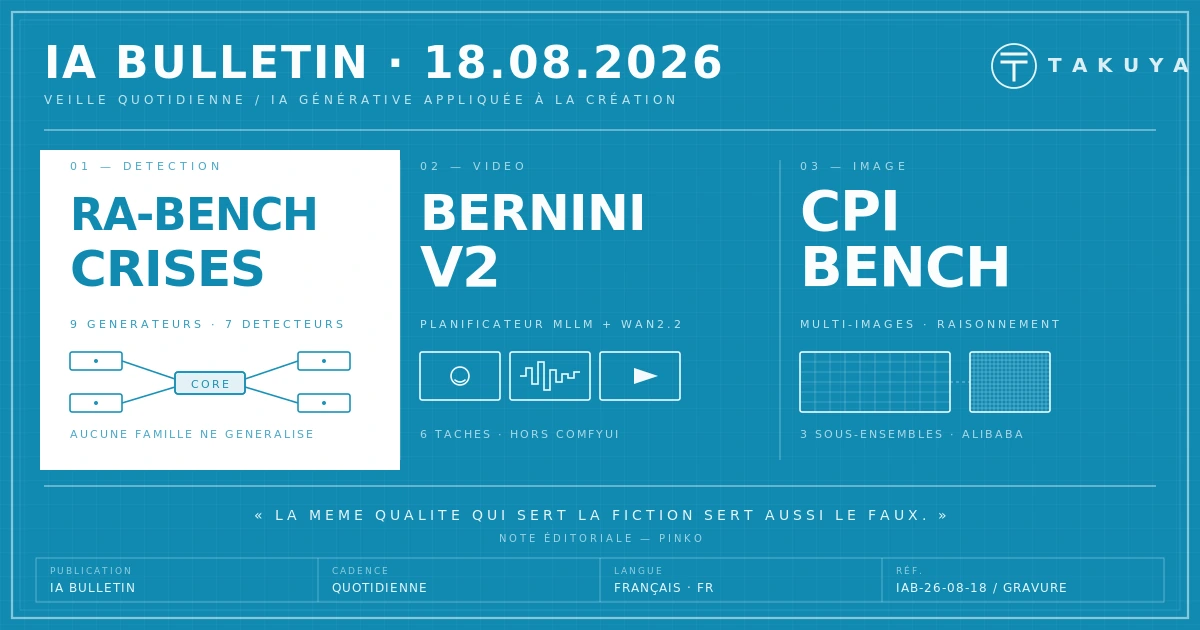
Une quarantaine de chercheurs ont publié RA-Bench, un banc d'essai de détection de vidéos générées qui prend pour référence des séquences authentiques plutôt que des synthèses isolées. L'ensemble réunit 17 886 vidéos : 1 830 ancres réelles réparties en dix catégories de risque social — guerres, catastrophes, urgences publiques — et 16 056 clips fabriqués par quatre générateurs ouverts et cinq générateurs fermés. Trois familles de détecteurs ont été passées au crible : sept détecteurs classiques, dix modèles multimodaux en zero-shot sous trois régimes de relecture, et deux modèles de langage multimodaux spécifiquement affinés sur la tâche. Aucune des trois ne généralise de façon constante, et le résultat le plus gênant tient en une phrase : les vidéos qui trompent les humains sont exactement celles que les machines ratent, tandis que la diffusion sociale — recompressions, recadrages, réencodages successifs — dégrade encore la fiabilité des détecteurs. Les propriétés de génération, qualité, conditionnement et graine d'échantillonnage, affectent chaque famille différemment, mais la signature du générateur d'origine reste stable d'une graine à l'autre.
Le chiffre à retenir n'est pas le nombre de vidéos mais la corrélation : ce qui trompe l'œil trompe aussi le détecteur, ce qui condamne la stratégie consistant à réparer après coup. La même qualité de rendu qui sert un plan de fiction sert une fausse séquence d'attentat, et aucun classifieur ne fera la différence entre les deux intentions puisqu'il ne voit que des pixels. C'est pourquoi le marquage à la source, C2PA en tête, n'est pas une contrainte administrative mais la seule piste qui survive à un recadrage et à trois réencodages. Reste que la charge en revient aux producteurs d'images plutôt qu'aux plateformes — un déplacement de responsabilité que le métier n'a pas encore vraiment intégré.