IA Bulletin — 22 août 2026

L'humain en 4D depuis une vidéo de poche /
L'image de groupe à dix identités /
Les mondes vidéo jouables en peu d'étapes /
La transcription calquée sur le barème

L'humain en 4D depuis une vidéo de poche

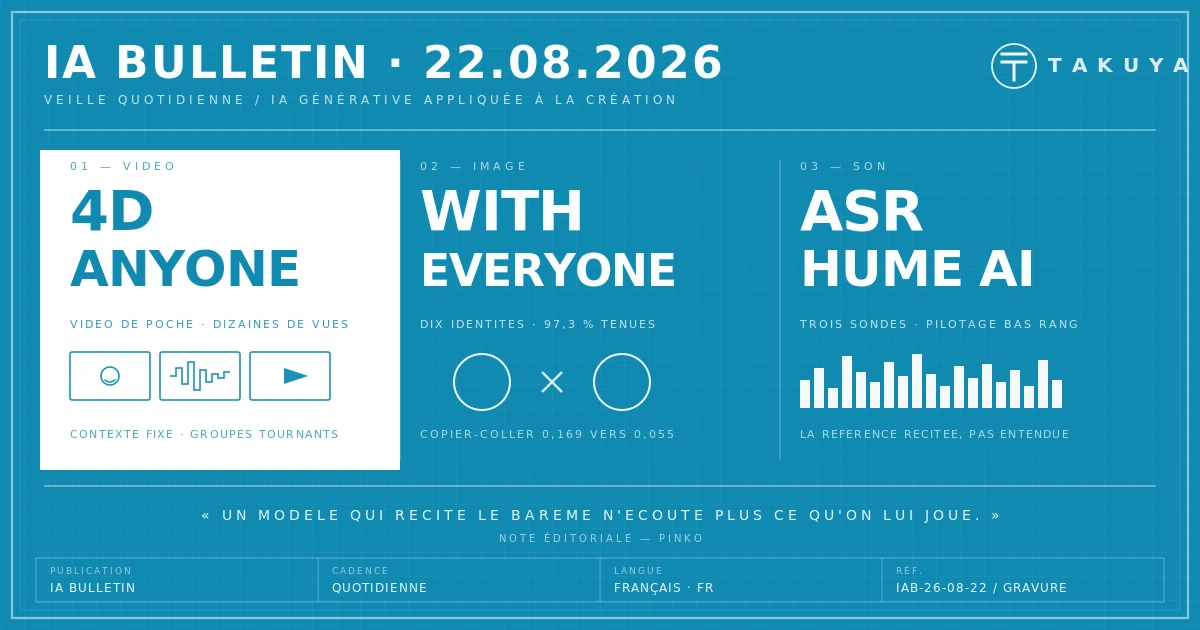
Reconstruire une personne en volume et en mouvement réclamait jusqu'ici un plateau multicaméra ; 4DAnyone, présenté par Ant Research avec les universités du Zhejiang et de Hong Kong, part d'une simple vidéo monoculaire non calibrée et en dérive des vues multiples assez cohérentes pour alimenter une reconstruction en splatting gaussien 4D. Les modèles de diffusion vidéo pilotés par caméra savent inventer une vue plausible, mais décrochent dès qu'il faut en tenir plusieurs dizaines à la fois : les auteurs nomment ce mur le problème du contexte d'attention borné, où le découpage en groupes affaiblit le guidage d'apparence et laisse la structure globale dériver. Deux mécanismes répondent à ces deux fuites, le Reference Context Packing qui comprime les vues déjà produites en un contexte de longueur fixe à coût constant, et le Target Context Routing qui fait tourner la composition des groupes pendant le débruitage — partage large aux étapes bruitées, stabilisation du détail aux étapes fines. L'entraînement combine un jeu maison, MVGameHuman, produit dans le moteur de jeu interne du laboratoire, avec des captations de studio lumineux et des vidéos tournées sans protocole. Les mesures sur DNA-Rendering et DyMVHumans placent la méthode devant l'état antérieur en qualité de vue nouvelle comme en reconstruction finale, avec du code et une page de projet publiés.

Note éditoriale

Le geste intéressant n'est pas la reconstruction, c'est le renoncement au plateau. Un studio qui filme un danseur au téléphone dans une cour d'immeuble se retrouve, en principe, avec la matière d'un plan tournant impossible à budgéter autrement — et c'est exactement le genre de bascule qui déplace une esthétique avant de déplacer un marché. Reste que les jeux d'évaluation sont des captations propres, corps entiers, lumière contrôlée : le fossé entre le banc d'essai et la vidéo réellement tournée à l'arrache demeure la seule question qui vaille. Le fait que le tout s'entraîne en partie sur des humains de moteur de jeu mérite aussi d'être gardé en tête quand on regarde les peaux et les tissus.
Sources : Hugging Face Daily Papers — 4DAnyone, Create Anyone in 4D from a Casual Monocular Video — arXiv:2608.20335 — 4DAnyone — page du projet

L'image de groupe à dix identités

Générer une image en préservant un visage de référence est devenu banal ; en préserver dix dans la même scène reste un champ de ruines, chaque identité devant être rattachée à une personne et à une place précises. WithEveryone, signé Tencent Hunyuan avec l'université Fudan, traite le problème en amont du rendu : chaque référence sélectionnée entre dans le modèle comme un jeton adressé, un plan structuré associant identités et disposition est prédit, puis ce plan devient lui-même une condition visuelle. L'objectif d'entraînement change également de nature, la Layout-Grounded ID Loss supervisant directement les régions de visage annotées au lieu de s'en remettre à un appariement instable entre plongements de visages bruités. Sur un banc d'essai dont les identités sont disjointes de l'entraînement, la similarité de visage passe de 0,462 pour GPT-Image-2 à 0,499, tandis que les artefacts de copier-coller — le défaut qui trahit immédiatement une image composée — chutent de 0,169 à 0,055, avec 97,3 % des identités demandées effectivement présentes pour seulement 2,8 % de doublons. Ce contrôle nominatif du placement intéresse directement le portrait de groupe d'une pochette d'album, où la question n'est jamais de fabriquer un visage mais de placer les bons, au bon endroit, sans que le collage se voie.

Note éditoriale

Le chiffre à retenir n'est pas la similarité de visage, c'est l'effondrement du taux de copier-coller. Il dit qu'on est passé d'un modèle qui recolle des têtes à un modèle qui les redessine en tenant la ressemblance — la différence entre un photomontage et une photographie de groupe, exactement le seuil qui sépare l'amusant de l'utilisable. Pour un visuel de disque à cinq ou six musiciens, la contrainte n'a jamais été la beauté des visages mais leur juste attribution, et c'est bien là que le plan explicite fait son travail. On notera tout de même que la démonstration se fait sur un banc d'essai maison, et que dix identités tenues sur une image restent une performance de laboratoire avant d'être une commande de studio.

Sources : Hugging Face Daily Papers — WithEveryone, Unified Planning and Identity Grounding for Group Image Generation — arXiv:2608.20336 — WithEveryone — page du projet

Les mondes vidéo jouables en peu d'étapes

Un modèle de monde vidéo conditionné par l'action doit produire l'image suivante assez vite pour qu'une main sur un clavier ne sente pas le retard, ce qui interdit les dizaines d'étapes de débruitage habituelles. ForgeWM répond par une distillation progressive en quatre temps — adaptation de domaine, entraînement causal guidé par la vérité terrain, distillation par cohérence causale, puis alignement de distribution en condition réelle face à un professeur bidirectionnel — dont sortent des élèves spécialisés opérant à un, deux ou quatre pas. La difficulté propre à l'interactivité tient à l'alignement : des états de clavier discrets et un mouvement de souris continu doivent rester synchronisés avec des blocs latents temporellement compressés, pendant l'entraînement comme pendant le déroulé autorégressif. Le déploiement se fait sur deux voies, l'une tenant la latence pendant le jeu, l'autre proposant un raffinement au moment de la relecture où l'élève à une étape re-bruite puis reprend son propre brouillon — un procédé qui rejoint la qualité de la version à quatre étapes tout en restant environ trois fois plus proche de la trajectoire réellement vécue qu'une régénération depuis le bruit. Testé sur des trajectoires Minecraft appariées puis transposé à un jeu de tir à la manette, l'ensemble est publié en code, modèle et jeu de données.

Note éditoriale

Le raffinement à la relecture est l'idée à voler. Elle sépare enfin deux régimes que la génération vidéo confondait : ce qu'on voit pendant qu'on manipule, et ce qu'on garde une fois la prise terminée — soit exactement la distinction entre l'écoute au casque en répétition et le mixage du lendemain. Toute installation générative en temps réel bute sur ce compromis, et personne n'avait proposé de le résoudre autrement qu'en sacrifiant l'un des deux côtés. Que la démonstration passe par Minecraft plutôt que par une œuvre n'enlève rien à la mécanique ; cela rappelle simplement d'où vient l'argent qui finance ces travaux.

Sources : Hugging Face Daily Papers — ForgeWM, Progressive Causal Training for Few-Step Action-Conditioned Video World Models — arXiv:2608.14022 — ForgeWM — page du projet

La transcription calquée sur le barème

Les classements publics de reconnaissance vocale servent d'étalon à toute la filière, du sous-titrage automatique aux outils de dérushage — et une équipe de Hume AI vient de montrer qu'ils mesurent en partie autre chose que ce qu'ils prétendent. La méthode consiste à fabriquer des situations où l'audio ne détermine pas la transcription attendue, puis à observer ce que le modèle écrit : désaccord délibéré entre le son et la référence, chiffres masqués à récupérer, changement de convention orthographique. Les modèles ouverts les mieux classés restituent mot pour mot des passages de la transcription de référence alors même que l'audio correspondant est contradictoire, masqué ou ambigu, ce qui n'est pas de la reconnaissance mais de la récitation. Des sondes mécanistes montrent que ce basculement est déclenché par des indices acoustiques étroits, et surtout qu'il se manipule de l'extérieur — par un pilotage linéaire de bas rang, ou plus trivialement en ajoutant un bout d'audio à la fin du segment. La conclusion est sobre et gênante : une partie des progrès affichés relève d'un comportement conditionné par le banc d'essai, sans gain correspondant sur la transcription tout-venant.

Note éditoriale

Voilà le genre de travail qui rend service à tout le monde sauf aux tableaux de classement. Quiconque a fait dérusher une interview par un outil réputé excellent connaît l'écart entre le score annoncé et le fichier rendu ; il a désormais un nom et un protocole de mesure. L'aspect le plus troublant reste la manipulabilité : si l'on peut activer ou désactiver la récitation en collant du son en fin de segment, c'est que le modèle a appris à reconnaître le contexte d'évaluation lui-même. À l'échelle d'un studio, la leçon tient en une ligne : tester les outils sur ses propres prises, jamais sur celles qui ont servi à les noter.

Sources : Hugging Face Daily Papers — Towards Quantifying Benchmark Optimization in ASR Models — arXiv:2608.19936 — Hume AI — dépôt de code
Frapper le tombeau — Studio Takuya