IA Bulletin — 3 octobre 2026

Midjourney et la retouche sur les seuls pixels choisis /
Suno Speech, la parole posée sur sa propre musique /
Eleven v4 et la voix dirigée par balises

Midjourney et la retouche sur les seuls pixels choisis

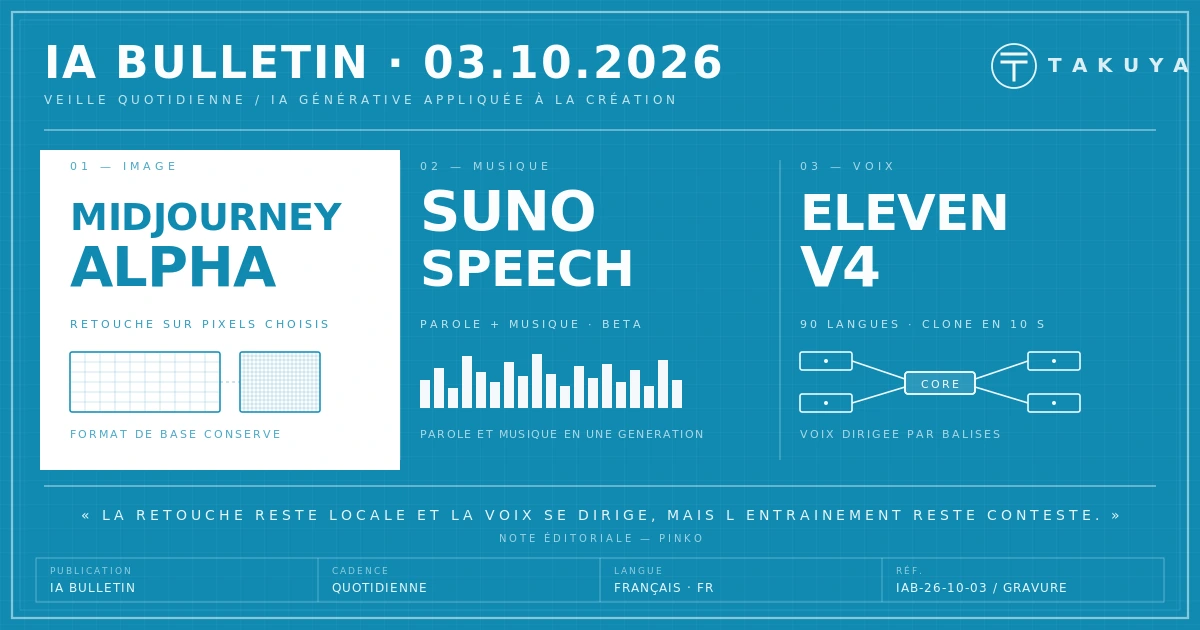
Midjourney publie le 1er octobre un nouveau journal de modifications pour son interface alpha, qui prolonge les retouches d'image annoncées le 24 septembre. Le modèle d'édition ne change désormais que les pixels sélectionnés, ce qui autorise des reprises successives d'une même zone sans dégrader le reste, et le paramètre --tile fait disparaître les raccords visibles entre tuiles en versions 8.1 et 8.2. Les éditions conservent le format de l'image de base, si bien qu'un --ar oublié dans le prompt ne déforme plus le résultat. Plusieurs références de style tiennent dans une seule pastille, les paramètres s'enregistrent par dossier et les moodboards acceptent le dépôt direct de fichiers, un détail pratique pour assembler le moodboard d'une pochette de disque. Midjourney annonce comme « bientôt » le partage et la génération collaboratifs, un historique d'édition persistant et de nouveaux outils d'exploration des styles, sans donner de date.

Note éditoriale

Retoucher sans défaire le reste, et garder le format d'origine : ces deux réglages relèvent de la discipline du fichier de travail plus que de la démonstration. Ils comptent pour qui reprend la même image vingt fois avant de la livrer.

La promesse d'un édit qui ne touche que la zone choisie reste celle de l'éditeur, et elle se vérifiera sur des images à fort détail, retouchées plusieurs fois de suite. Les moodboards ouverts au glisser-déposer rapprochent l'outil des habitudes de direction artistique, où l'on commence par rassembler des références.
Sources : Midjourney — Alpha Changelog 10/1/26 — Midjourney — Edit updates, thumbnail previews, and more (24 septembre 2026)

Suno Speech, la parole posée sur sa propre musique

Suno lance le 1er octobre Speech (bêta), présenté comme son premier modèle capable de produire de la parole et son accompagnement musical en une seule génération. Les exemples de la société vont de l'histoire du soir sur piano doux au discours de motivation sur tambours de stade, jusqu'à la liste de courses en ASMR, sur mobile comme sur le web. La fonction suit de trois semaines la famille v6, v6-wild et v6-mini, sortie le 9 septembre, qui apportait l'édition de sections, les mashups et les entrées multimodales. Le 18 septembre, Sony Music et Universal Music Group ont déposé une nouvelle plainte de 45 pages qui nomme 60 202 enregistrements et réclame jusqu'à 9 milliards de dollars de dommages et intérêts statutaires. Suno avait d'abord déclaré v6 entraîné « entièrement à partir de zéro » avant de préciser que l'entraînement s'appuie sur des interactions d'utilisateurs, dont leurs créations, ce que les plaignants décrivent comme le fruit du même arbre empoisonné, et les notes de version de Speech ne disent rien de ses données d'entraînement.

Note éditoriale

Une voix qui récite sur un lit musical généré brouille la frontière entre le livre audio, la publicité et le morceau. L'intérêt pour les créateurs tient au mixage obtenu d'un seul geste, avec pour contrepartie que la voix et la musique deviennent difficiles à séparer à l'export.

Le calendrier judiciaire rappelle qu'un nouveau nom de version ne règle pas la question des données d'entraînement. Entre « à partir de zéro » et « à partir d'interactions d'utilisateurs », l'écart de formulation est celui que les plaignants contestent, et que Suno n'a pas encore documenté pour Speech.

Sources : Suno — Release notes (Speech bêta, 1er octobre 2026) — Bedroom Producers Blog — Suno confirms v6 is trained on user-generated interactions (26 septembre 2026)

Eleven v4 et la voix dirigée par balises

ElevenLabs lance le 28 septembre Eleven v4 et Eleven v4 Turbo, deux modèles de synthèse vocale, le premier pour la qualité d'expression et le second pour la vitesse dans les agents conversationnels. La direction se fait en langage naturel et par des balises insérées dans le texte, qui commandent un rire, un accent précis ou un bruit de pluie légère. Les deux modèles couvrent plus de 90 langues, avec un accent mieux tenu quand une voix clonée change de langue, et un clone instantané se fait à partir de dix secondes d'audio. Pour Turbo, ElevenLabs annonce un délai médian d'environ 150 millisecondes avant la première parole, la première place du classement d'Artificial Analysis et la préférence d'environ 75 % des auditeurs en test à l'aveugle, des chiffres qui restent ceux de l'éditeur. Runway a ouvert Eleven v4 dans son API le 30 septembre, avec des scripts jusqu'à 2 500 caractères et un tarif d'introduction de 2,2 crédits par 1 000 caractères jusqu'au 12 octobre, puis 5 crédits, selon le relevé de Releasebot.

Note éditoriale

Diriger une voix par des indications de jeu plutôt que par des curseurs rapproche la synthèse vocale de la direction d'acteur : on décrit une intention, pas une courbe. Pour le clip, le podcast ou le doublage, la tenue de l'accent d'une langue à l'autre ouvre des usages concrets.

Dix secondes d'audio suffisent aussi à cloner une voix qui n'a donné aucun accord, et les classements cités viennent de l'éditeur ou d'un comparateur tiers. L'écoute sur ses propres textes reste le seul test qui compte, et le consentement de la voix source, une question de contrat avant d'être une question technique.

Sources : ElevenLabs — Eleven v4 — ElevenLabs — Changelog du 28 septembre 2026 — Releasebot — Runway AI Release Notes
2304-shaolin — Studio Takuya