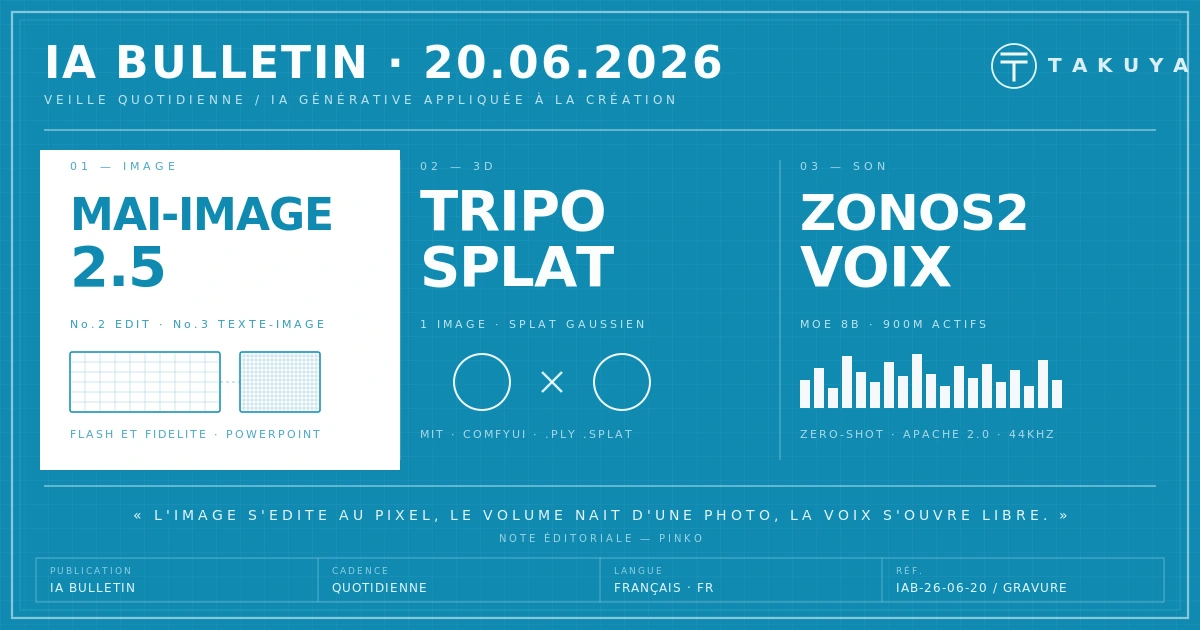
IA Bulletin — 20 juin 2026

MAI-Image-2.5 au sommet de l'édition /
TripoSplat et le volume 3D depuis une photo /
ZONOS2 et la voix clonée ouverte

Microsoft hisse MAI-Image-2.5 au sommet de l'édition d'image

Microsoft a confirmé le 17 juin la disponibilité de MAI-Image-2.5, sommet actuel de sa famille maison de sept modèles MAI dévoilée à la conférence Build 2026, qui réunit la génération texte-vers-image et l'édition image-vers-image dans un seul système de diffusion. Le modèle se classe deuxième sur le banc « édition » de l'Arena, devant Nano Banana 2.1, et troisième en texte-vers-image avec un score d'environ 1 254 points, en hausse de soixante-douze points sur la version précédente. Microsoft livre deux variantes : une version haute fidélité et une version Flash trois fois moins chère en sortie, pensée pour les pipelines à fort volume. L'accent est mis sur les retouches chirurgicales — suppression d'objet, remplacement de texte, cohérence d'identité et de composition d'une itération à l'autre —, un terrain qui rejoint le travail réel sur l'identité visuelle d'un album. Le modèle est déjà déployé dans PowerPoint, OneDrive et Bing, signe que Microsoft le traite comme une infrastructure de production et non comme une démonstration.

Note éditoriale

Le signal n'est pas le classement mais le glissement de terrain : la bataille de l'image quitte la génération pure pour l'édition fine, là où se joue le travail quotidien d'un studio. Un modèle qui tient l'identité d'un visage ou d'une typographie sur dix retouches successives vaut davantage qu'un modèle qui éblouit sur une seule invite. Que Microsoft cesse de tout router vers OpenAI pour pousser sa propre fonderie dans ses logiciels grand public dit aussi combien l'image générée est devenue un actif stratégique.
Sources : Microsoft AI — Introducing MAI-Image-2.5 — WaveSpeed — MAI-Image-2.5 API: What Builders Should Know

TripoSplat transforme une seule image en nuage 3D gaussien

L'équipe TripoAI / VAST AI Research a publié TripoSplat, un modèle open source sous licence MIT qui transforme une unique photographie en objet 3D, exporté au format .ply ou .splat. La sortie n'est pas un maillage classique mais un nuage de gaussiennes — des milliers de primitives colorées qui restituent l'objet sous tous les angles, rendu en temps réel et visuellement riche. L'architecture est directe : une image entre, un dorsal visuel de la famille DINO et un décodeur produisent jusqu'à 262 144 gaussiennes, sans calibrage de caméra ni prises multiples, la face cachée étant inventée à partir d'a priori. Le code, d'environ deux mille lignes, et des poids de 3,8 Go sont sur Hugging Face, et ComfyUI embarque depuis la version 0.23.0 un gabarit natif couvrant détourage, conditionnement et décodage. L'outil vise l'aperçu rapide, la prévisualisation produit rotative et la référence 3D pour des chaînes 2D — pas l'actif de jeu prêt à truquer, qui réclame toujours une vraie topologie.

Note éditoriale

L'intérêt n'est pas de remplacer le modeleur mais de combler un trou : passer d'une photo à un volume que l'on fait tourner dans le navigateur en une seule inférence. Le piège est de prendre ce générateur d'aperçus pour un scanner 3D fidèle — la face invisible reste une hypothèse, pas une mesure. Pour un créatif, la vraie valeur est ailleurs : générer un volume, le rendre sous de nouveaux angles, et nourrir un travail 2D d'images de référence inédites.

Sources : GitHub — VAST-AI-Research / TripoSplat — WaveSpeed — TripoSplat: Image-to-3D Gaussian Splatting

Zyphra ouvre ZONOS2, voix clonée en temps réel à poids libres

Le laboratoire Zyphra a présenté ZONOS2, qu'il décrit comme le premier modèle de synthèse vocale open source à mélange d'experts, publié sous licence Apache 2.0. L'architecture parcimonieuse compte huit milliards de paramètres dont neuf cents millions seulement s'activent à l'inférence, pour un rendu audio haute fidélité à 44,1 kHz généré en temps réel. Sa fonction phare est le clonage vocal sans apprentissage préalable : à partir de quelques secondes de référence, le modèle restitue le timbre, la cadence et l'accent d'une voix, conditions d'enregistrement comprises. Entraîné sur plus de six millions d'heures et traitant le texte comme un flux brut d'octets UTF-8, il améliore nettement les langues non européennes comme le japonais, le chinois et le coréen. Les poids sont disponibles sur Hugging Face et le code d'inférence sur GitHub, ouvrant la voix de synthèse à quiconque dispose d'une machine correcte.

Note éditoriale

Mettre une voix clonable en poids libres déplace la question du « peut-on » vers le « doit-on » : la prouesse technique est acquise, le cadre d'usage reste à écrire. Pour un musicien, l'outil ouvre des terrains réels — voix de référence, doublure de maquette, narration multilingue — sans dépendre d'un service fermé. Mais une voix qui se clone en quelques secondes est aussi une signature qui se vole en quelques secondes, et c'est cette ambivalence, plus que les paramètres, qui mérite l'attention.

Sources : Zyphra — ZONOS2 — GitHub — Zyphra / ZONOS2
Without Bone — Studio Takuya