IA Bulletin — 21 juin 2026

La musique générative en temps réel /
La voix de synthèse expressive ouverte /
L'entraînement vidéo sur mesure

Google ouvre Magenta RealTime 2, la musique générée en temps réel

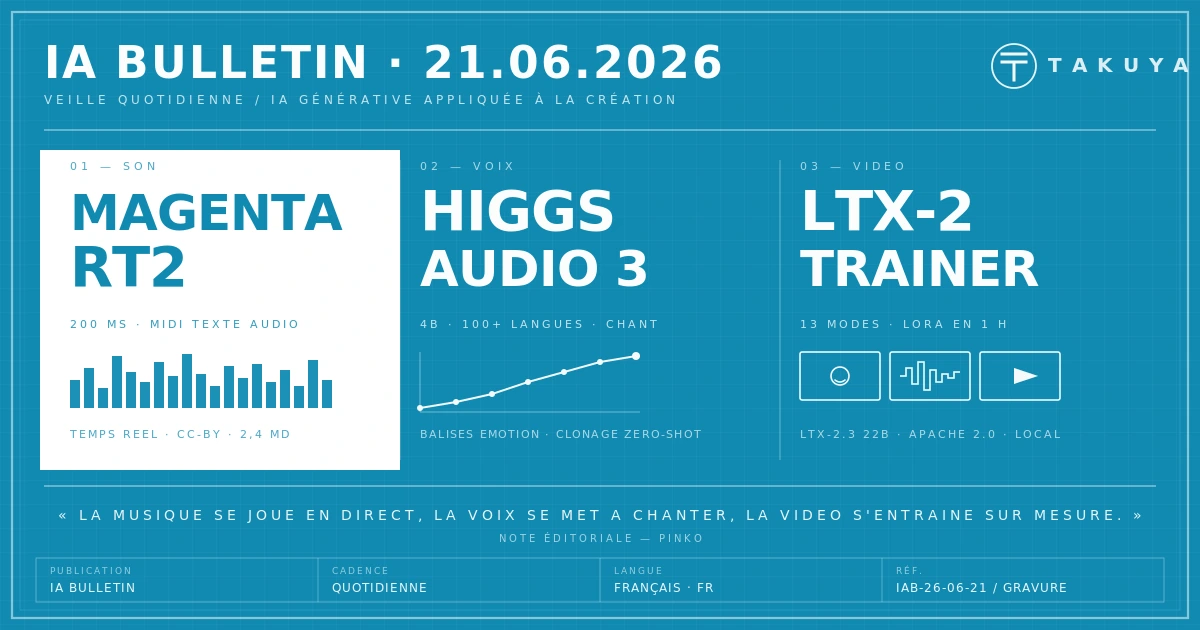
Google a publié le 4 juin Magenta RealTime 2, un modèle à poids ouverts de génération musicale pensé pour jouer en direct plutôt que pour rendre un fichier. La latence de contrôle tombe à environ 200 millisecondes, contre près de trois secondes dans la première version, soit une réactivité quinze fois supérieure, pilotable au fil de l'eau par texte, audio et MIDI. Le système se décline en deux tailles, un modèle Base de 2,4 milliards de paramètres et un modèle Small de 230 millions qui tourne jusque sur un ordinateur portable léger. Le code est sous licence Apache 2.0 et les poids sous Creative Commons Attribution, disponibles sur Hugging Face, ce qui en fait le seul modèle à poids ouverts capable de générer un flux musical continu en temps réel à cette latence. On entre dans le flux pendant qu'il joue, comme on tournerait le bouton d'un synthétiseur analogique — un morceau né ainsi reste un morceau qui devra ensuite trouver sa forme et sa création visuelle d'album.

Note éditoriale

La rupture n'est pas la qualité du rendu mais la latence : sous deux cents millisecondes, un modèle cesse d'être un générateur pour devenir un instrument que l'on joue. Que Google place ce modèle en poids ouverts, jouable sur un simple portable, déplace la musique générative du presse-bouton vers le geste continu. Reste la question que la fluidité masque : un instrument se maîtrise, et un flux qui ne s'arrête jamais demande encore qu'on sache quoi en faire.
Sources : Google Magenta — Magenta RealTime 2 — Hugging Face — google/magenta-realtime-2

Boson AI publie Higgs Audio v3, la voix de synthèse qui chante

Le laboratoire Boson AI a publié le 4 juin Higgs Audio v3, un modèle de synthèse vocale de quatre milliards de paramètres conçu pour parler, et non seulement pour lire un texte. Il couvre plus de cent langues, dont environ quatre-vingt-cinq à qualité de production, et permet le clonage de voix sans apprentissage préalable à partir d'une courte référence. Sa singularité tient à des balises de contrôle insérées directement dans le texte : une vingtaine d'émotions, des styles comme le chant, le murmure ou le cri, des pauses et des effets sonores, modifiables au sein d'une même phrase. Le temps avant le premier son passe sous la seconde, ce qui le rend utilisable pour des agents vocaux et des maquettes interactives. Les poids sont publiés sur Hugging Face sous licence non commerciale et l'API hébergée est en préversion gratuite, plaçant la voix expressive qui chante à portée de quiconque dispose d'une machine correcte.

Note éditoriale

L'enjeu se déplace de la voix qui lit vers la voix qui interprète : chuchoter, crier, chanter sur commande, c'est franchir la frontière entre diction et jeu d'acteur. Pour un créatif, l'outil ouvre des usages réels — narration, doublure de maquette, voix chantée de référence — sans dépendre d'un studio. Mais une voix qui chante sur étiquette pose, encore, la question du consentement de celles et ceux dont le timbre nourrit le modèle.

Sources : Boson AI — Higgs Audio v3 TTS — Hugging Face — bosonai/higgs-audio-v3-tts-4b

Lightricks ouvre l'entraînement vidéo sur mesure avec le LTX-2 Trainer

Lightricks a ouvert en juin le LTX-2 Trainer, un cadre d'entraînement unifié pour son modèle vidéo open source LTX-2.3. Un seul fichier de configuration couvre désormais treize modes d'entraînement, de la vidéo au son en passant par des objectifs croisés image-vers-vidéo. Le dispositif rend reproductible l'entraînement de LoRA et d'IC-LoRA, ces adaptateurs légers qui spécialisent un modèle sur un mouvement, un style ou une identité visuelle précise. Lightricks indique que l'apprentissage d'un mouvement, d'un style ou d'une ressemblance peut s'achever en moins d'une heure selon les configurations. Le modèle sous-jacent, un transformeur de diffusion de vingt-deux milliards de paramètres sous licence Apache 2.0, génère jusqu'à vingt secondes de vidéo en 4K avec son synchronisé, désormais entraînable sur mesure et en local.

Note éditoriale

L'intérêt n'est pas un modèle de plus mais la bascule de l'entraînement vers l'atelier : spécialiser une vidéo sur son propre style en une heure, en local, sans pipeline de laboratoire. C'est l'écart entre consommer un modèle générique et façonner un outil à sa main. Le revers tient dans le mot ressemblance — entraîner sur une identité précise est aussi la porte ouverte à l'imiter sans qu'elle l'ait voulu.

Sources : GitHub — Lightricks / LTX-Video — Hugging Face — Lightricks/LTX-2.3
Provinciales — Studio Takuya