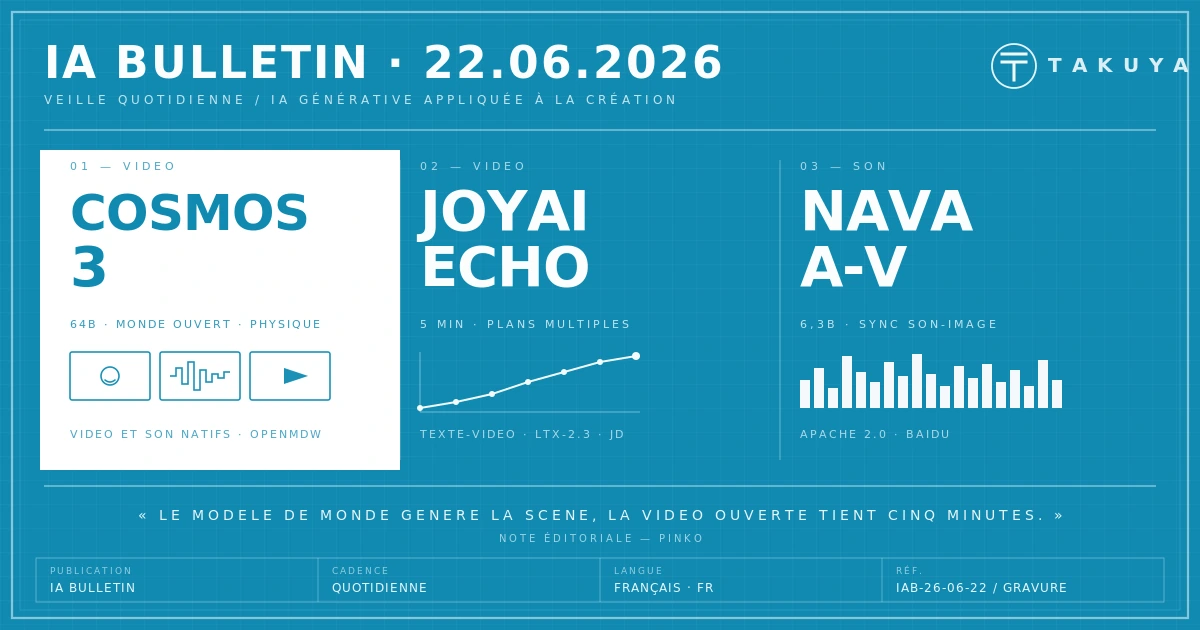
IA Bulletin — 22 juin 2026

Le modèle de monde ouvert à la génération vidéo /
La vidéo générative étendue à cinq minutes /
Le son et l'image générés d'un seul geste

NVIDIA ouvre Cosmos 3, le modèle de monde qui génère la vidéo et le son

NVIDIA a publié le 1er juin Cosmos 3, présenté comme le premier modèle de monde entièrement ouvert capable de comprendre et de générer nativement texte, images, vidéo et son ambiant, ainsi que des trajectoires d'action. Le vaisseau amiral, Cosmos3-Super, articule deux tours pour soixante-quatre milliards de paramètres au total — un raisonneur de trente-deux milliards et un générateur de trente-deux milliards — sur une architecture de mélange de transformeurs. Sa promesse tient en un mot, la précision physique : les scènes générées respectent la gravité, les collisions et la continuité du mouvement, là où les modèles vidéo habituels hallucinent la matière. Pensé d'abord pour la robotique et les véhicules autonomes, il est diffusé en poids ouverts sous licence OpenMDW sur Hugging Face, donc inspectable et exécutable hors de tout service propriétaire. Pour un créatif, l'intérêt n'est pas le robot mais le moteur : un générateur qui tient la cohérence physique d'un plan ouvre la voie à une vidéo générative enfin crédible dans la durée.

Note éditoriale

Un modèle de monde n'est pas un modèle vidéo de plus : il prétend comprendre comment les choses tombent, se heurtent et persistent, et c'est précisément ce que la génération créative ne sait pas faire. Que NVIDIA le publie en poids ouverts plutôt qu'en service fermé met cette physique à portée d'un atelier, pas seulement d'un laboratoire de robotique. Reste que la cohérence physique d'un plan n'a jamais été, à elle seule, une intention de mise en scène.
Sources : NVIDIA — Cosmos 3 Technical Report — Hugging Face — nvidia/Cosmos3-Super

JD ouvre JoyAI-Echo, la vidéo générée en plans multiples sur cinq minutes

Le groupe chinois JD a publié JoyAI-Echo, un système de génération vidéo à partir de texte capable de produire jusqu'à cinq minutes de séquence en plans multiples. Le modèle s'appuie sur la pile ouverte LTX-2.3 de Lightricks, déjà connue pour sa génération 4K et son audio synchronisé, qu'il prolonge du clip court vers le récit continu. La rupture porte moins sur la qualité d'un plan que sur la continuité narrative : tenir des personnages, un décor et une lumière cohérents d'une coupe à l'autre, sur plusieurs minutes. C'est exactement la limite contre laquelle butaient les générateurs vidéo, cantonnés jusqu'ici à des fragments de quelques secondes vite oubliés. Diffusé dans la même vague de poids ouverts que le reste de la semaine, JoyAI-Echo rapproche le montage long d'une fabrication sans pipeline de studio.

Note éditoriale

La vraie frontière de la vidéo générative n'a jamais été la beauté d'un plan, mais la capacité à en enchaîner plusieurs sans que le monde se réinvente à chaque coupe. Bâtir sur LTX-2.3 plutôt que sur un modèle propriétaire ancre cette durée dans un terrain réutilisable, modifiable, local. Cinq minutes cohérentes ne font pas un film, mais elles déplacent enfin la question du fragment vers celle du montage.

Sources : Mervin Praison — Open-Weight AI Release Week (juin 2026) — Hugging Face — Lightricks/LTX-2.3

Baidu publie NAVA, la génération conjointe du son et de l'image

Baidu a ouvert NAVA, un modèle de 6,3 milliards de paramètres qui génère conjointement le son et l'image, plutôt que d'ajouter une bande-son après coup. Son argument est la synchronisation audiovisuelle : la voix, le bruit et le mouvement des lèvres ou des objets sont calés dès la génération, sans recalage manuel. Le modèle est diffusé sous licence Apache 2.0, ce qui autorise l'usage commercial et l'intégration dans des chaînes de production locales. Pour un musicien ou un vidéaste, un générateur qui fait naître le son et l'image d'un seul geste change la fabrique du clip, où l'image et la direction artistique d'un album doivent déjà parler la même langue. NAVA reste un premier jalon, mais il installe la synchronisation native comme la prochaine évidence des modèles créatifs.

Note éditoriale

Générer le son et l'image ensemble plutôt qu'à la chaîne n'est pas un détail technique : c'est reconnaître qu'un plan et sa bande-son sont une seule et même décision. Tant que les outils séparaient les deux, le créatif rabibochait après coup ce qui aurait dû naître lié. Que ce premier pas arrive sous Apache 2.0 compte autant que la prouesse : la synchronisation devient un bien commun, pas une fonctionnalité premium.

Sources : Mervin Praison — Open-Weight AI Release Week (juin 2026) — Digg — More than 25 open-weight models in a single week
Early Adopters — Studio Takuya