IA Bulletin — 23 juin 2026

Le modèle qui écoute et regarde en parlant /
L'atelier local qui remplace un visage dans un plan /
La voix clonée sans le moindre jeton

Thinking Machines dévoile l'« interaction model », l'IA qui écoute, regarde et parle en même temps

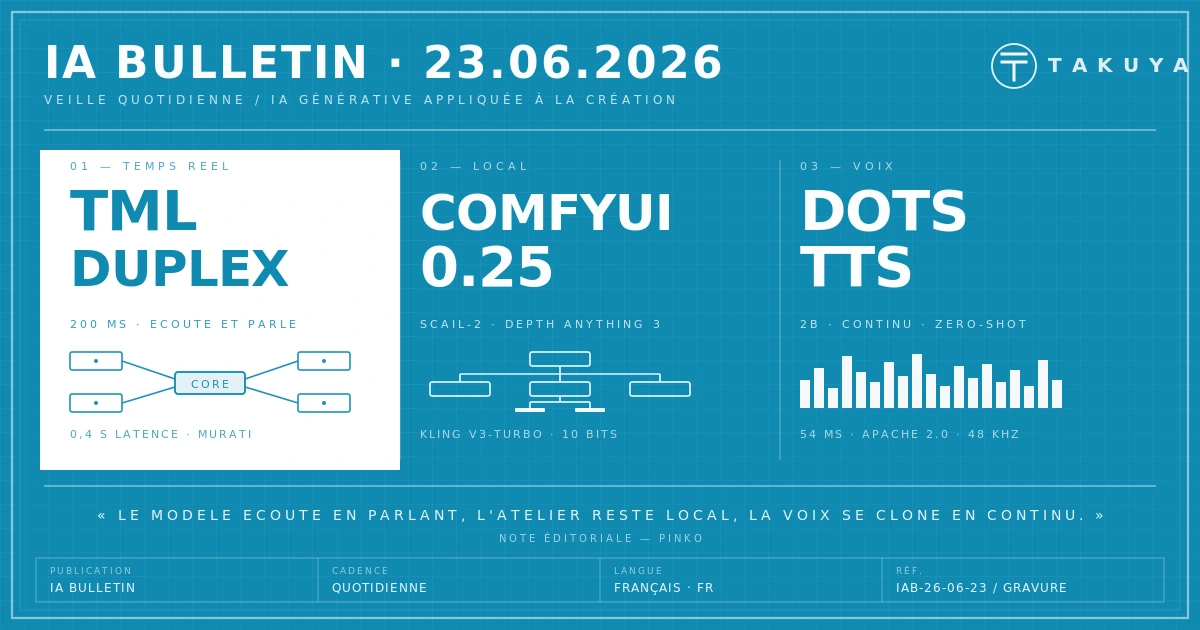
Thinking Machines Lab, le laboratoire fondé par l'ancienne directrice technique d'OpenAI Mira Murati, a présenté en juin son tout premier modèle, baptisé interaction model. Là où un assistant vocal attend la fin de la phrase pour répondre, ce système full-duplex traite l'audio, la vidéo et le texte par tranches de deux cents millisecondes — des « micro-tours » — pour écouter, regarder, réfléchir et parler simultanément. Sa latence de prise de parole tombe à quatre dixièmes de seconde, soit le tempo d'une conversation humaine, et il devance les modèles temps réel d'OpenAI et de Google sur les interruptions et les bruits de fond. L'architecture sépare une partie « présence », toujours à l'écoute et consciente du temps qui passe, d'une partie d'arrière-plan qui mène les raisonnements longs et les appels d'outils. Pour qui pense l'installation interactive ou la performance, c'est moins un chatbot de plus qu'un partenaire scénique capable de tenir le rythme du direct.

Note éditoriale

Le temps réel n'est pas un gadget de démonstration : c'est la différence entre un outil qu'on interroge et une présence avec laquelle on joue. Tant que la machine attendait la fin de la phrase, elle restait un guichet ; qu'elle écoute en parlant la rapproche du musicien qui répond à un autre sur scène. Reste à savoir quoi dire à quelqu'un qui ne se tait jamais — une latence basse ne garantit pas la justesse de l'écoute.
Sources : Thinking Machines Lab — Interaction Models — The Decoder — Thinking Machines Lab ships its first model

ComfyUI 0.25 ajoute le remplacement de personnage et la profondeur en local

L'atelier open-source ComfyUI a publié le 16 juin ses versions 0.25.0 et 0.25.1, qui élargissent encore ce qu'on peut faire tourner sur sa propre machine. La 0.25.0 intègre Depth Anything 3 pour estimer la profondeur d'une simple image, le modèle SCAIL-2 qui remplace un personnage dans un plan vidéo, le support vidéo Bernini-R de la famille Wan, et l'entrée-sortie vidéo en 10 bits. La 0.25.1 ajoute dans la foulée la prise en charge de Kling V3-Turbo. Aucun de ces ajouts n'est un modèle phare tonitruant : ce sont des briques de production — détourer, conditionner, substituer, étalonner — assemblées dans un graphe de nœuds inspectable. C'est exactement là que se joue la direction artistique d'une pochette ou d'un clip quand on tient à garder ses fichiers et ses choix sur son disque plutôt que dans un service distant.

Note éditoriale

La vraie nouvelle n'est pas un modèle de plus mais l'endroit où il tourne. Quand le remplacement de personnage et l'étalonnage 10 bits entrent dans un atelier local et libre, la souveraineté cesse d'être un slogan pour devenir un réglage. Le graphe de nœuds n'a rien de séduisant au premier regard, mais c'est lui qui rend chaque étape relisible — donc défendable.

Sources : ComfyUI — Changelog v0.25.0 / v0.25.1 — GitHub — Comfy-Org/ComfyUI Releases

dots.tts clone une voix en continu, sans jamais passer par des jetons

Hilab, la division recherche du réseau social chinois RedNote, a publié le 9 juin dots.tts, un système de synthèse vocale de deux milliards de paramètres entièrement continu. Son originalité tient à un refus : à aucun moment la voix n'est découpée en jetons discrets, le modèle travaillant de bout en bout dans un espace latent continu jusqu'à un rendu en 48 kHz. Il clone une voix en zéro-shot et la diffuse en flux avec une latence de premier paquet de 54 millisecondes, assez basse pour une diction quasi instantanée. Le code et les poids — y compris une version distillée et un portage pour puces Apple Silicon — sont publiés sous licence Apache 2.0, donc librement exploitables en local. Comme toujours avec le clonage vocal, la prouesse technique arrive sans le mode d'emploi éthique qui devrait l'accompagner.

Note éditoriale

Supprimer les jetons, c'est rapprocher la voix de synthèse du grain continu d'une voix réelle, et le résultat se mesure en millisecondes gagnées. Mais une voix clonée en zéro-shot sous licence permissive, c'est aussi un masque vocal posé à portée de tous, sans verrou ni traçabilité. L'ouverture qui sert le créateur sert exactement aussi bien le faussaire — l'outil ne tranche pas, il déplace la responsabilité vers celui qui s'en saisit.

Sources : arXiv — dots.tts Technical Report — Hugging Face — rednote-hilab/dots.tts-base
Divine Machine (live) — Studio Takuya