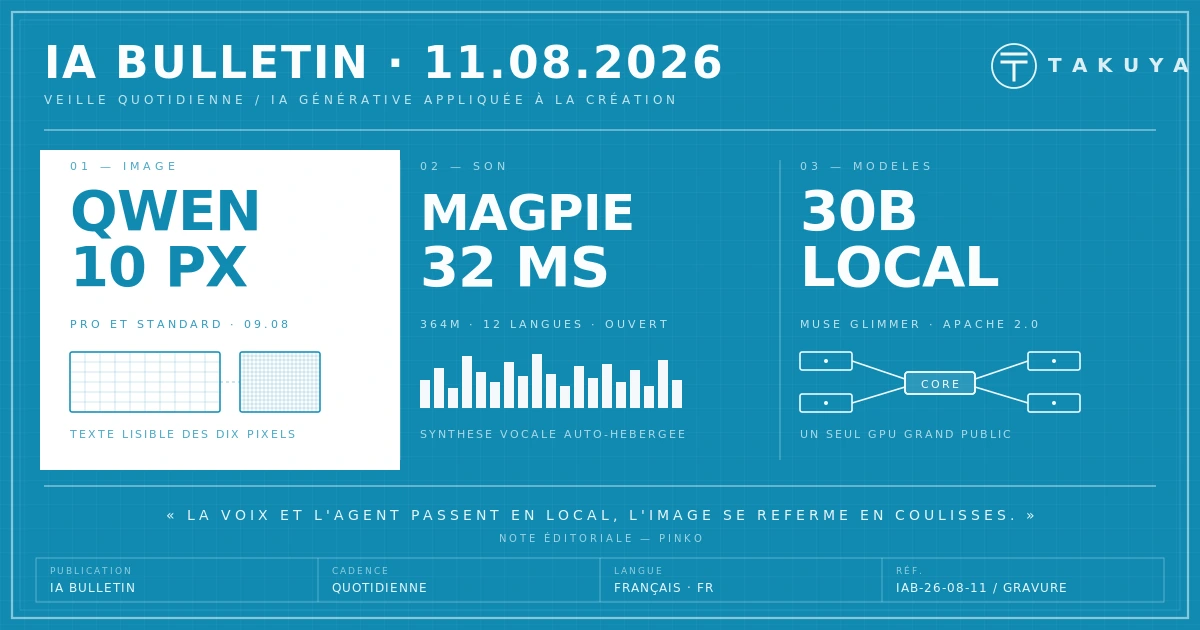
IA Bulletin — 11 août 2026

Le texte au pixel près chez Qwen-Image /
La voix ouverte en 32 millisecondes /
Le trente-milliards local de Meta

Le texte au pixel près chez Qwen-Image

Alibaba a mis en ligne le 9 août les versions Pro et Standard de Qwen-Image-3.0 sur Qwen Cloud, sortant le modèle de la phase d'accès sur invitation ouverte fin juillet. Le générateur accepte des prompts jusqu'à 4 500 tokens — 4,5 fois la génération précédente — et s'en sert pour composer en une seule passe des mises en page complètes : unes de journaux, copies d'examen avec notation mathématique, planches de bande dessinée, grilles de neuf infographies. L'éditeur revendique un texte lisible dès dix pixels, des formules LaTeX multi-lignes et douze langues rendues nativement dans plus de vingt polices — une maîtrise du lettrage qui rejoint les exigences de la composition typographique d'une pochette d'album. Les démonstrations empilent quatre interfaces imbriquées dans une seule image et restaurent une peinture à l'encre de Chine abîmée en respectant le geste du pinceau d'origine. Rupture assumée avec les deux premières générations, publiées en poids ouverts avec évaluations : Qwen-Image-3.0 arrive sans benchmarks, sans rapport technique et sans poids — un produit fermé, plus une publication de recherche.

Note éditoriale

Le texte dans l'image a longtemps été le test qui faisait rire — six doigts, lettres fondues. Le voici devenu argument commercial : dix pixels lisibles, c'est le corps d'une mention légale sur un packaging ou d'un crédit au dos d'un disque. Reste l'objection de fond : une page générée est une image plate, non éditable — un beau brouillon, pas un document de production. La vraie information est ailleurs : le champion chinois des poids ouverts vient de refermer sa gamme image, sans un chiffre publié.
Sources : The Decoder — Alibaba's Qwen-Image-3.0 renders ten-pixel text — AI Models Navi — AI News Aug 10

La voix ouverte en 32 millisecondes chez NVIDIA

NVIDIA a publié le 10 août les poids ouverts de Magpie TTS Multilingual, un modèle de synthèse vocale de 364 millions de paramètres parlant douze langues, dont le français, l'arabe et le coréen. Le chiffre qui compte : 32 millisecondes entre la requête et le premier échantillon audio sur GPU B200, la latence en dessous de laquelle un agent vocal semble converser plutôt que réciter. Le modèle sort sous licence NVIDIA Open Model, s'auto-héberge via le toolkit NeMo et s'accompagne d'un blueprint complet d'agent vocal chaînant reconnaissance, LLM et synthèse. Cinq voix intégrées et des taux d'erreur caractère de 0,34 à 3,17 % selon la langue ; le clonage de voix zero-shot a été volontairement retiré, par précaution. Pour un studio, l'équation change : narration et doublage multilingues à coût marginal nul, sans compteur par caractère, et un audio qui ne quitte jamais la machine — l'argument décisif des productions sous NDA.

Note éditoriale

Trente-deux millisecondes, c'est moins qu'une double-croche à 120 BPM — la voix machine entre dans le domaine du temps réel musical, celui où l'oreille ne perçoit plus d'attente. Le retrait du clonage dessine en creux la ligne de partage du marché : l'infrastructure s'ouvre, l'identité vocale reste un produit sous licence. Cinq voix d'usine ne feront pas une direction artistique ; elles feront très bien tourner les maquettes, les guides et tout ce qui précède la vraie prise.

Sources : NVIDIA (Hugging Face) — Magpie TTS Multilingual for voice agents — Creative AI News — NVIDIA Magpie TTS: Open-Weights Voice Agent Model

Le trente-milliards local de Meta

Meta a publié le 10 août Muse Glimmer, un modèle agentique de 30 milliards de paramètres en poids ouverts sous licence Apache 2.0, téléchargeable sur Hugging Face. Distillé de Muse Spark, le modèle fermé le plus puissant de la maison, il est calibré pour tourner sur un seul GPU grand public avec 131 000 tokens de contexte. La cible revendiquée : des agents locaux toujours actifs — assistants de code, évaluation LLM-as-judge, automatisation de tâches — sans dépendance au cloud ni sortie de données. Le lancement s'accompagne d'un lobbying assumé : Zuckerberg presse Washington d'abaisser les barrières sur l'open source américain pour contrer la montée des poids ouverts chinois. Pour un poste de travail créatif, un 30B de ce calibre ouvre l'orchestration de chaînes entières — files ComfyUI, tri de rushes, métadonnées de catalogue — depuis une simple station, données comprises.

Note éditoriale

La carte de l'ouverture se redistribue en une seule journée : la voix passe en local chez NVIDIA, l'agent chez Meta, pendant que l'image de pointe se referme chez Alibaba. La logique est lisible — ce qui coûte cher et rapporte gros se vend en API, ce qui installe un écosystème se distribue gratuitement. Aux ateliers d'en tirer la conséquence pratique : bâtir les chaînes de production sur ce qui tient dans la machine, et traiter le reste comme un robinet qui peut se fermer sans préavis.

Sources : TechCrunch — Meta's new Glimmer AI model — Engadget — Meta's Muse Glimmer can run on a single computer
Senkya Shi — Studio Takuya