IA Bulletin — 19 août 2026

La timeline retrouvée pour MiniMax H3 /
L'accord de Hollywood avec ByteDance /
L'animation humaine en flux continu /
Les fils Reddit mis en voix

La timeline retrouvée pour MiniMax H3

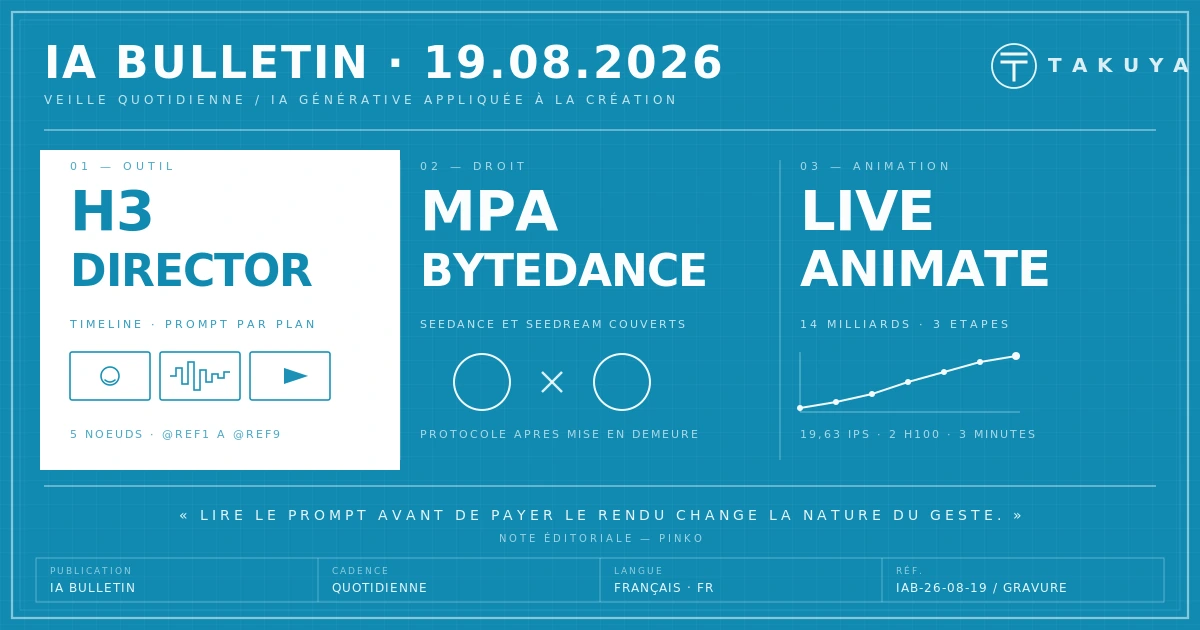
ComfyUI-MiniMaxH3-Director installe un véritable éditeur de montage à l'intérieur de ComfyUI, porté depuis le LTX Director de WhatDreamsCost : on dépose images, vidéos et musique sur des pistes, on les rogne sur une règle graduée en secondes ou en images, et on écrit un prompt par plan. La bascule tient dans un détail que les nœuds natifs n'offraient pas : le prompt compilé destiné au modèle s'affiche en direct, si bien qu'il se relit avant qu'un rendu ne soit dépensé pour rien. Cinq nœuds composent l'ensemble — le Director lui-même, une surcharge d'aperçu qui montre le plan entier se débruiter, un raccord de reprise qui réinjecte une plage régénérée dans la vidéo de base, un rédacteur de prompt confié à un modèle de vision local et un enregistreur de dernière image. Les fentes @ref1 à @ref9 reçoivent chacune une nature — décor, accessoire, style — et un curseur de rétention allant de la conservation stricte à la référence faible, logique familière à qui prépare l'assemblage visuel d'une pochette d'album à partir de plusieurs sources d'intensité inégale. La version 0.2.2 réclame ComfyUI 0.30.0 au minimum, aucun paquet Python supplémentaire, et bascule seule entre les points de contrôle FL2VA et REF2VA selon que les références sont actives ou non.

Note éditoriale

Voir le prompt avant de payer le rendu : la fonction paraît anodine, elle change pourtant la nature du geste. Tant que la consigne reste opaque, chaque itération est une loterie dont le coût se mesure en minutes de GPU ; dès qu'elle devient lisible, le travail redevient de la réécriture, c'est-à-dire du métier. Le retour de la timeline dans un environnement de nœuds dit aussi quelque chose de l'époque : après dix-huit mois passés à câbler des graphes, l'outil qui gagne est celui qui ressemble à une table de montage. Reste que ce confort est un greffon communautaire, pas une brique officielle — la dépendance à un dépôt tiers est le prix courant de l'ergonomie dans cet écosystème.
Sources : ComfyUI Wiki — MiniMax H3 Director, Timeline Storyboard Editor for ComfyUI — GitHub — ComfyUI-MiniMaxH3-Director — Hugging Face — Comfy-Org/MiniMax-H3

L'accord de Hollywood avec ByteDance

La Motion Picture Association et ByteDance ont annoncé un protocole d'accord mondial destiné à encadrer la propriété intellectuelle dans les modèles génératifs du groupe chinois. Le texte couvre l'ensemble des modèles maison, ceux qui alimentent TikTok, la coentreprise TikTok USDS, CapCut et Dreamina, avec en première ligne le générateur vidéo Seedance et le générateur d'images Seedream. Il conclut six mois de bras de fer : en février, l'association — Disney, Paramount et Warner Bros. Discovery parmi ses membres — avait adressé une mise en demeure après la sortie de Seedance 2.0, dont les utilisateurs tiraient sans effort des variations sur Brad Pitt ou Tom Cruise, et le déploiement mondial de cette version avait été suspendu. La MPA affirme que les livraisons récentes, Seedance 2.5 et Seedream 5.0 Pro, intègrent déjà les garde-fous négociés, et son président Charles Rivkin parle de garanties concrètes obtenues par la discussion plutôt que par le tribunal. Le contraste est net avec l'autre dossier ouvert du secteur, la plainte que les mêmes studios maintiennent contre Midjourney.

Note éditoriale

Un protocole d'accord n'est pas une licence : il n'ouvre aucun catalogue, ne verse aucun droit et ne dit rien des œuvres déjà avalées pendant l'entraînement. Ce qu'il installe, c'est un filtre en sortie — la capacité de refuser un visage ou un costume reconnaissable au moment de la génération. La distinction compte pour qui produit des images sous contrat : le risque juridique se déplace du modèle vers le prompt, et donc vers celui qui l'écrit. Deux régimes coexistent désormais, la négociation pour ceux qui disposent d'une plateforme de distribution à échanger, le procès pour les autres.

Sources : Motion Picture Association — MPA and ByteDance announce global agreement — Variety — Motion Picture Association strikes deal with ByteDance — Dataconomy — ByteDance signs AI copyright agreement with Hollywood

L'animation humaine en flux continu

Une équipe rattachée à la division Qwen d'Alibaba a présenté LiveAnimate, système d'animation de personnage qui anime une photographie unique à partir d'un flux de poses, en temps réel et sur la durée. Le modèle est un transformeur de diffusion vidéo de 14 milliards de paramètres converti en générateur autorégressif par blocs, puis distillé jusqu'à un budget de trois étapes d'échantillonnage seulement. Le verrou n'était pas la vitesse mais la dérive : au bout de quelques dizaines de secondes, les systèmes de ce type perdent le visage, le vêtement, la carnation. La réponse s'appelle PR-Sink, un cache borné qui conserve en permanence le tout premier bloc généré, y adjoint un bloc historique retrouvé par similarité de pose et trois créneaux glissants — quand une posture revient, l'apparence correspondante revient avec elle, sans que la mémoire ni la latence n'augmentent avec la durée du flux. Le résultat annoncé est de 19,63 images par seconde sur deux cartes H100, avec une qualité perçue quasi constante entre la trentième seconde et la troisième minute, là où les systèmes hors ligne se dégradent ou réclament des heures de calcul.

Note éditoriale

L'idée intéressante n'est pas le nombre d'images par seconde mais la mémoire indexée sur la pose : le système ne retient pas le passé, il sait le retrouver quand un geste se répète. C'est très exactement ce que fait un animateur qui range ses poses clés dans un dossier et y revient au lieu de tout redessiner. Deux H100 pour animer une photographie restent hors de portée d'un atelier, et l'usage visé — avatars, téléprésence, direct — n'est pas celui de la fiction. Mais la technique de cache, elle, descendra dans les modèles plus petits, et c'est là qu'elle deviendra utile.

Sources : Hugging Face Daily Papers — LiveAnimate, Stable Long-Form Streaming Human Animation in Real-Time — arXiv:2608.11745 — LiveAnimate — page du projet

Les fils Reddit mis en voix

Reddit a lancé une expérimentation limitée qui transforme certains fils textuels en séquences audio et en vidéos courtes, sur son site comme dans ses applications. Le dispositif ne touche qu'un échantillon de messages dans quelques communautés, les publications d'origine restent intactes et les nouveaux formats renvoient vers elles. L'exemple mis en avant est parlant : une question vieille de huit ans, posée sur r/boardgames à propos de jeux à emporter en voiture, devient un clip de trois minutes qui énonce la demande puis les meilleures réponses tout en les affichant à l'écran, avec ce qui ressemble à des voix de synthèse. La plateforme ne dit pas comment les fils sont sélectionnés, mais l'intention est assumée depuis la dernière présentation de résultats, où son dirigeant observait qu'un genre entier prospère ailleurs sur internet — des podcasts qui se contentent de lire du Reddit à voix haute. Le mouvement prolonge l'ajout des commentaires vidéo en juin, et confirme qu'un forum de texte se convertit désormais en flux.

Note éditoriale

Le fil de discussion n'a jamais été un script, et c'est précisément ce qui rendait sa lecture supportable : on saute, on revient, on abandonne. Le convertir en clip narré impose une durée là où il n'y avait qu'un parcours, et rend au passage la parole d'un contributeur à une voix qui n'est pas la sienne. Reste la question du consentement, que l'expérimentation contourne en laissant le texte d'origine intact — argument commode, qui ne dit rien de la voix prêtée. La leçon utile pour un studio est ailleurs : chaque archive écrite est désormais un stock de matière première pour la synthèse vocale, y compris la sienne.

Sources : Dataconomy — Reddit tests AI-voiced videos based on user posts — Reddit Inc. — blog officiel
What Ever Happened To Alain — Studio Takuya