IA Bulletin — 20 août 2026

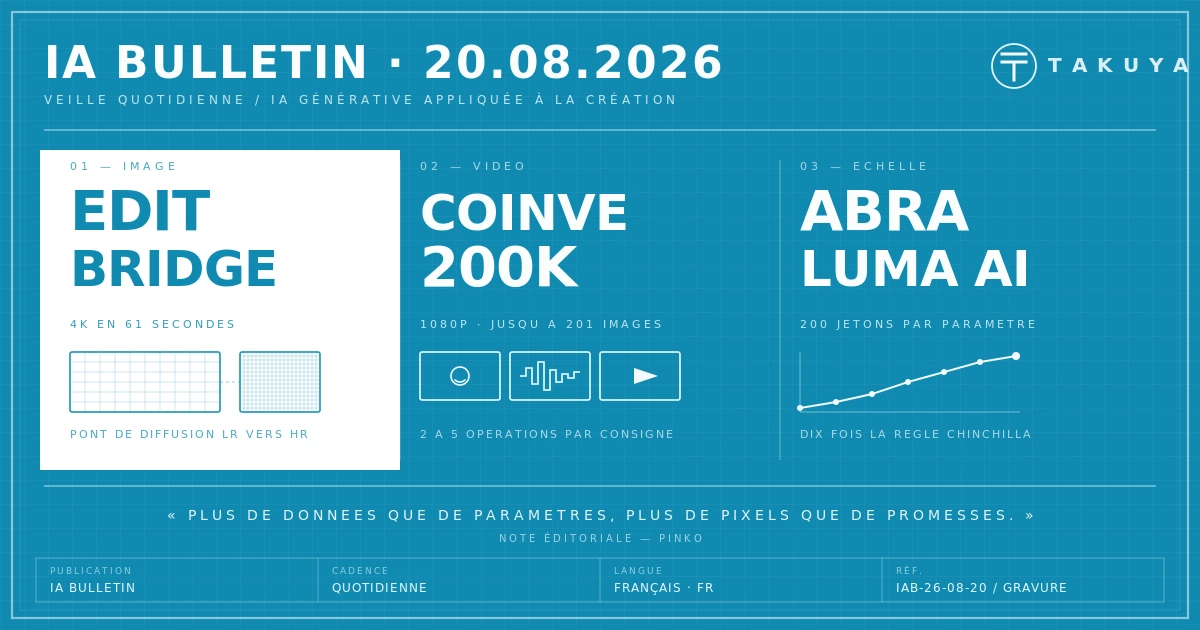
L'édition d'image en 4K /
Le montage vidéo à instructions multiples /
Les lois d'échelle de la diffusion /
Les corpus pensés par capacité

L'édition d'image en 4K

Les modèles d'édition d'image par diffusion plafonnent aujourd'hui sous le millier de pixels de côté, parce que le coût de l'attention croît avec le carré du nombre de jetons et que la mémoire suit. Le contournement habituel — éditer en basse définition puis agrandir séparément — produit deux défauts documentés par l'équipe de EditBridge : la divergence d'information, où l'agrandissement invente des détails qui contredisent la source, et la dégradation de texture, qui donne des surfaces trop lissées ou trop accentuées. La proposition renverse la logique : au lieu de régénérer depuis du bruit, le modèle traite le passage de la version basse définition éditée vers sa contrepartie haute définition comme une traduction de données à données, explicitement conditionnée par l'image source d'origine. Pour que ce conditionnement reste abordable, une attention creuse par blocs réutilise les correspondances sémantiques établies lors de la première passe et limite les échanges entre les deux images aux régions spatialement alignées. Les mesures annoncent une accélération de 3,6 à 8,4 fois en 2K et une édition 4K bouclée en 61 secondes, seuil à partir duquel la retouche générative cesse d'être un aller-retour de laboratoire pour devenir une étape de production — celle que réclame par exemple la préparation haute définition d'une pochette d'album destinée à l'impression.

Note éditoriale

Le point de bascule n'est pas la résolution affichée mais la fidélité à la source. Depuis deux ans, tout agrandissement génératif se paie en détails inventés que personne n'a demandés, et un studio qui livre un fichier d'impression ne peut pas plaider la surprise. Conditionner la montée en définition sur l'original plutôt que sur une hallucination cohérente, c'est ramener l'outil du côté de la retouche et non de la réinterprétation. Reste que 61 secondes en 4K décrivent un banc d'essai, pas une station de travail : la question du matériel nécessaire n'est pas tranchée dans l'article.
Sources : Hugging Face Daily Papers — EditBridge, Towards Faithful and Efficient Ultra-High-Resolution Image Editing — arXiv:2608.18063 — EditBridge — page du projet

Le montage vidéo à instructions multiples

Tencent met en ligne CoinVE-200K, un jeu de données d'édition vidéo guidée par consigne dont la particularité tient en un mot : composition. Les corpus existants entraînent les modèles à exécuter une opération à la fois, alors qu'une demande réelle en empile plusieurs — retirer un objet, changer le fond, styliser un personnage — et qu'il faut les comprendre ensemble avant de les appliquer à la même séquence. Chaque échantillon associe donc une vidéo 1080p allant jusqu'à 201 images à une consigne portant sur deux à cinq opérations atomiques, ajout, suppression, modification ou stylisation, appliquées aux personnes, aux objets ou aux décors. L'ensemble s'accompagne d'un banc d'essai, CoinVE-Bench, et d'un modèle de démonstration de 22 milliards de paramètres bâti sur Wan2.1-T2V-14B et Qwen3-VL-8B-Instruct, qui sépare l'attention par région selon la consigne visée afin de retoucher plusieurs zones sans abîmer le reste de l'image ni rompre la continuité temporelle. Données, banc d'essai, poids et démonstration sont publiés simultanément sur Hugging Face, ce qui rend la chaîne reproductible plutôt que déclarative.

Note éditoriale

La composition d'instructions est exactement ce qui sépare une démonstration d'un outil de montage. Personne ne demande à un monteur de retirer un lampadaire puis, dans une seconde passe, de changer la lumière : la demande arrive entière, et chaque passe supplémentaire dégrade un peu plus l'image d'origine. Ce que documente ce corpus, c'est le coût réel de cette évidence — deux cent mille paires fabriquées et filtrées pour apprendre à ne pas casser le reste du plan. L'ouverture simultanée du jeu de données et du modèle mérite d'être notée : la plupart des annonces de cette semaine s'arrêtent à l'article.

Sources : Hugging Face Daily Papers — CoinVE-200K, A Large-Scale High-Quality Dataset for Compositional Instruction-Guided Video Editing — arXiv:2608.17566 — CoinVE-200K — page du projet

Les lois d'échelle de la diffusion

Les lois d'échelle guident depuis des années l'entraînement des modèles de langage, mais restaient largement inexplorées du côté de la génération visuelle. Luma AI comble le trou avec Abra, une famille contrôlée de transformeurs à appariement de flux entraînés sur trois ordres de grandeur de calcul, de 1019 à 1022 FLOPS, soit des budgets nettement supérieurs à ceux des travaux antérieurs. Le résultat central : la diffusion texte-image se comporte de façon aussi prévisible que le langage, mais réclame beaucoup plus de données pour un modèle de taille donnée — l'optimum de calcul se situe autour de 200 jetons d'image par paramètre, dix fois la prescription Chinchilla établie pour les grands modèles de langage. Deuxième enseignement, contre-intuitif pour qui vient du texte : ces modèles supportent le surentraînement sans dommage, si bien qu'en cas de doute il vaut mieux ajouter des données que grossir l'architecture. La régularité déborde enfin la seule perte d'entraînement puisqu'elle s'étend aux métriques de qualité générative, au réglage optimal du guidage sans classifieur, à la qualité des représentations et jusqu'à la forme des courbes d'apprentissage, qui se superposent toutes sur un tracé universel.

Note éditoriale

Un facteur dix sur le rapport données/paramètres, ce n'est pas une nuance de laboratoire : cela redéfinit qui peut prétendre entraîner un modèle d'image de premier plan. La course cesse d'être une affaire de cartes graphiques pour redevenir une affaire de catalogue, donc de droits, donc de licences — et l'on comprend mieux pourquoi les accords se multiplient en ce moment autour des corpus visuels. Pour un studio, la conséquence est indirecte mais réelle : la valeur se déplace vers les archives qualifiées, y compris les siennes. Reste une prudence de lecture, la famille Abra est un banc contrôlé et non un modèle de production, et rien ne garantit que les mêmes pentes tiennent à budget encore supérieur.

Sources : Hugging Face Daily Papers — Abra, Scaling Diffusion Image Training — arXiv:2608.17286

Les corpus pensés par capacité

La génération d'image à grande échelle a beaucoup progressé sur le volume, la qualité et le réétiquetage des données, mais les chaînes de préparation continuent d'optimiser chaque tâche dans son coin. Alibaba propose de renverser l'ordre : plutôt que de constituer un corpus par tâche, organiser la supervision selon les dépendances entre capacités, puisqu'un modèle doit savoir ancrer un texte dans une image avant de savoir transformer une image en une autre. Trois moteurs de données complémentaires produisent respectivement l'ancrage texte-image, la transformation d'une image vers une autre et l'association entre image et connaissance, pendant que des experts de légendage alignent les descriptions entre génération et édition à différentes granularités. Un cursus en plusieurs étapes fait ensuite évoluer conjointement la composition des tâches, la distribution des concepts visuels, la qualité et la résolution, l'évaluation par capacité refermant la boucle par recherche ciblée et rééchantillonnage des lacunes. À l'échelle, l'infrastructure produit 440 millions d'images pour la génération, 120 millions de paires d'édition et plus de 27 millions d'associations image-entité, sur lesquelles sont entraînés depuis zéro deux modèles de diffusion multimodaux de 3 et 6 milliards de paramètres.

Note éditoriale

Une leçon d'atelier déguisée en article de recherche : l'ordre dans lequel on apprend compte autant que ce qu'on apprend. Aucun graphiste ne commence par la retouche fine avant de savoir lire une commande, et il aura fallu quatre années de mise à l'échelle brute pour que la discipline redécouvre la progression pédagogique. Le chiffre de 440 millions d'images rappelle au passage l'échelle réelle du sujet — cette recette n'est reproductible que par une poignée d'acteurs. Ce qui redescendra, en revanche, c'est l'idée : mieux vaut un corpus ordonné qu'un corpus gonflé.

Sources : Hugging Face Daily Papers — From Corpora to Co-Evolving Capabilities, Capability-Centric Data Design for Generalist Image Generation — arXiv:2608.18076
Futur Antérieur — Studio Takuya