IA Bulletin — 16 septembre 2026

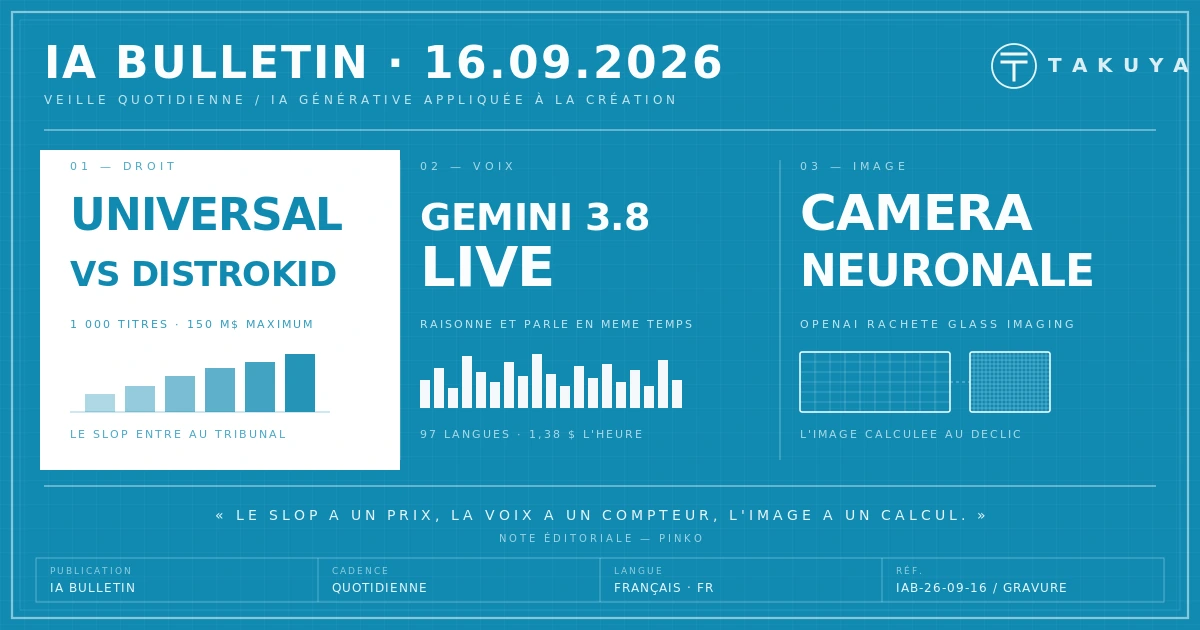
Universal contre DistroKid et le procès du slop /
La voix qui raisonne en parlant chez Google /
L'image calculée dès l'obturateur chez OpenAI /
Music v2.5 et la propriété des morceaux

Universal contre DistroKid et le procès du slop

Universal Music Group a déposé le 15 septembre devant le tribunal fédéral du Delaware une plainte contre DistroKid, premier distributeur mondial en volume, qui revendique « environ 40 % » des nouveautés de la planète et plus de quatre millions d'artistes. La major accuse le distributeur de pratiques commerciales trompeuses et de contrefaçon, et l'écrit sans détour : DistroKid « inonde les plateformes de slop généré par IA » qui détourne écoutes et revenus des artistes réels. Le texte prend soin de préciser que le litige ne vise pas la distribution de musique générée lorsqu'elle est déclarée comme telle, mais la façade d'un catalogue présenté comme porté par des humains, alors que, selon le rapport SIQA du premier trimestre, 75,8 % des 1 551 titres IA soumis aux classements transitaient par DistroKid et 90,4 % sortaient de Suno. Les pièces jointes nomment 1 000 enregistrements, soit 150 millions de dollars de dommages statutaires au maximum, qu'Universal qualifie de partie émergée de l'iceberg, en reprochant surtout au distributeur de continuer à diffuser un titre sur d'autres services après avoir admis ne pas en détenir les droits. La plainte tombe le lendemain de la Streaming Integrity Initiative de l'IFPI, un jeu de principes anti-fraude signé par 24 acteurs dont les trois majors, qui impose un contrôle d'identité des clients et des mesures d'identification des contenus générés, et que DistroKid, comme TuneCore et UnitedMasters, n'a pas signé.

Note éditoriale

Le mot « slop » entre dans un acte judiciaire, et c'est le vrai événement. Il désignait jusqu'ici une gêne esthétique, un flux d'images et de sons sans adresse ; le voilà transformé en préjudice chiffré, avec un tarif par œuvre et un distributeur pour porter la responsabilité. Universal n'attaque pas la génération, elle attaque l'anonymat de la génération, et la suite se devine : une étiquette « IA » obligatoire à l'entrée des plateformes, dont la major aura écrit le cahier des charges.

Reste que le distributeur poursuivi est aussi la porte d'entrée de millions de musiciens indépendants qui n'ont jamais touché à un modèle. Le rapport de force se joue entre deux industries, celle des catalogues et celle des volumes, et l'artiste qui presse ses propres disques n'est invité à la table d'aucune des deux. La question de fond n'est pas de savoir qui triche, mais qui décidera demain de ce qui a le droit de s'appeler musique sur une plateforme.

Sources : Music Business Worldwide — Universal Music Group sues DistroKid, accusing it of 'flooding platforms with AI-generated slop' — Music Business Worldwide — DistroKid hasn't yet signed IFPI's new anti-fraud standards

La voix qui raisonne en parlant chez Google

Google DeepMind a mis en ligne le 15 septembre Gemini 3.8 Live et Gemini 3.8 Live Extended Thinking, deux modèles de dialogue vocal en temps quasi réel, disponibles dans l'API Gemini, AI Studio, l'application Gemini, Search Live et les outils Workspace. Le premier, conçu pour l'échelle et le coût, traite des entrées visuelles en direct, bascule de lui-même entre 97 langues au cours d'une conversation et exécute appels d'outils et d'API en arrière-plan sans interrompre l'échange. Le second raisonne et parle en même temps, meuble l'attente d'un « laissez-moi vérifier » et narre l'avancement des tâches longues ; il prend la première place de l'indice Speech to Speech d'Artificial Analysis avec 82,6 points, devant GPT-Live-1 d'OpenAI sorti cinq jours plus tôt. Google facture 0,005 dollar la minute d'audio en entrée et 0,018 en sortie, soit environ 1,38 dollar l'heure de conversation contre au moins 3 dollars chez OpenAI, dont le modèle full-duplex reste toutefois le seul à écouter et parler simultanément. Tout l'audio produit est marqué par le filigrane inaudible SynthID, et les démonstrations montrent le modèle transformer des croquis en composants React ou disputer une partie d'échecs à la voix, caméra allumée.

Note éditoriale

Un modèle qui parle pendant qu'il pense, c'est la fin d'un artefact que tout le monde avait fini par accepter : le silence de calcul. Pour qui travaille le son, ce détail en dit long ; la conversation devient un flux continu, avec ses hésitations fabriquées et ses « laissez-moi vérifier » écrits par un ingénieur pour paraître humains. La prosodie, elle aussi, est désormais un paramètre de produit.

La guerre des prix entre Google et OpenAI se joue au millième de dollar la minute, et c'est le signal le plus clair : la voix synthétique n'est plus un exploit, c'est une commodité facturée au compteur, comme le kilowatt. Ce qui restera rare n'est pas la voix, c'est ce qu'on lui fait dire, et le filigrane SynthID, s'il tient ses promesses, sera la seule trace de qui parlait vraiment.

Sources : Google — Introducing Gemini 3.8 Live and 3.8 Live Extended Thinking — The Decoder — Google launches Gemini 3.8 Live to take on OpenAI's GPT-Live-1 at a fraction of the cost

L'image calculée dès l'obturateur chez OpenAI

OpenAI a racheté Glass Imaging pour plus de 300 millions de dollars, selon le Wall Street Journal repris par TechCrunch le 14 septembre, une jeune pousse de Los Altos fondée en 2019 qui n'avait levé qu'une trentaine de millions. Ses fondateurs, Ziv Attar et Tom Bishop, sont deux anciens ingénieurs d'Apple qui dirigeaient l'équipe à l'origine du mode Portrait de l'iPhone. Leur approche ne retouche pas la photo après coup : des réseaux de neurones apprennent le comportement optique de chaque module de caméra pour produire une meilleure image au moment même du déclenchement, en contournant les limites physiques d'un capteur de téléphone. L'acquisition s'inscrit dans les projets matériels prêtés à OpenAI, téléphone, écouteurs, appareil compagnon sans écran, après le rachat pour 6,5 milliards de dollars de la société io de Jony Ive en 2025. Pour un studio qui prépare le cadrage photographique d'une pochette de disque, la nouvelle confirme que la frontière entre capture et génération se déplace vers l'intérieur de l'appareil, là où l'image naît déjà d'un calcul.

Note éditoriale

Le mode Portrait fut la première image de masse fabriquée par un réseau de neurones sans que personne ne parle d'intelligence artificielle : un flou de profondeur inventé, accepté par des milliards de gens comme une photographie. Ceux qui l'ont conçu rejoignent aujourd'hui l'entreprise dont les modèles produisent des images sans caméra du tout. Les deux pratiques, en réalité, ne se sont jamais vraiment quittées.

L'enjeu n'est pas la qualité des pixels, il est dans la question que posait déjà l'Apple Reference Image la semaine dernière : que reste-t-il de la prise de vue quand l'obturateur déclenche un modèle plutôt qu'une exposition ? Une caméra OpenAI signerait ses images d'un côté et les générerait de l'autre ; la provenance deviendra une affaire de degré, non de nature.

Sources : TechCrunch — OpenAI buys smartphone camera maker Glass Imaging for $300 million, report says

Music v2.5 et la propriété des morceaux chez ElevenLabs

ElevenLabs a publié le 11 septembre Music v2.5, désormais modèle par défaut d'ElevenMusic pour la génération par consigne et par référence, et disponible dans ElevenCreative et l'API. Sur 47 885 paires de morceaux générés à consigne identique, les auditeurs ont préféré la nouvelle version dans la majorité des cas, l'écart se creusant sur les genres à voix et à instruments acoustiques, R&B, soul, hip-hop, rock, métal et orchestral. L'entreprise insiste surtout sur la propriété : chaque morceau appartient à son auteur sur tous les forfaits, gratuit compris, avec cinq téléchargements sans perte par jour en accès libre sous condition de crédit, et 400 par mois en Pro. Les droits acquis à la création restent attachés au morceau en cas de résiliation, un changement futur des conditions ne s'appliquant qu'aux titres postérieurs, à l'exception des pistes construites sur la chanson d'un autre artiste, dont le téléchargement est bloqué. ElevenLabs affirme avoir entraîné ses modèles sur des stems et musiques sous licence sans en détailler la provenance, et précise que son accord pluriannuel récent avec Universal concerne des produits distincts, pas Music v2.5.

Note éditoriale

Le vrai argument de vente n'est plus le son, c'est la clause. « Ce que vous faites est à vous » devient le slogan d'un secteur où Suno rationne les téléchargements et où les modèles anciens s'éteignent du jour au lendemain ; ElevenLabs vend une permanence, celle du fichier, à défaut de celle de la plateforme.

Le test d'écoute à l'aveugle mesure une préférence, pas une signature : quarante-huit mille paires jugées plus naturelles disent quelque chose sur la moyenne du goût, rien sur la voix singulière d'un producteur. Le modèle produit désormais des instruments crédibles ; il reste à savoir qui, devant le clavier, a quelque chose à leur faire jouer.

Sources : ElevenLabs — Introducing Music v2.5, our best music model yet — The Decoder — Elevenlabs makes Music v2.5 available via app and API
So Long — Studio Takuya