Dix secondes pour une voix
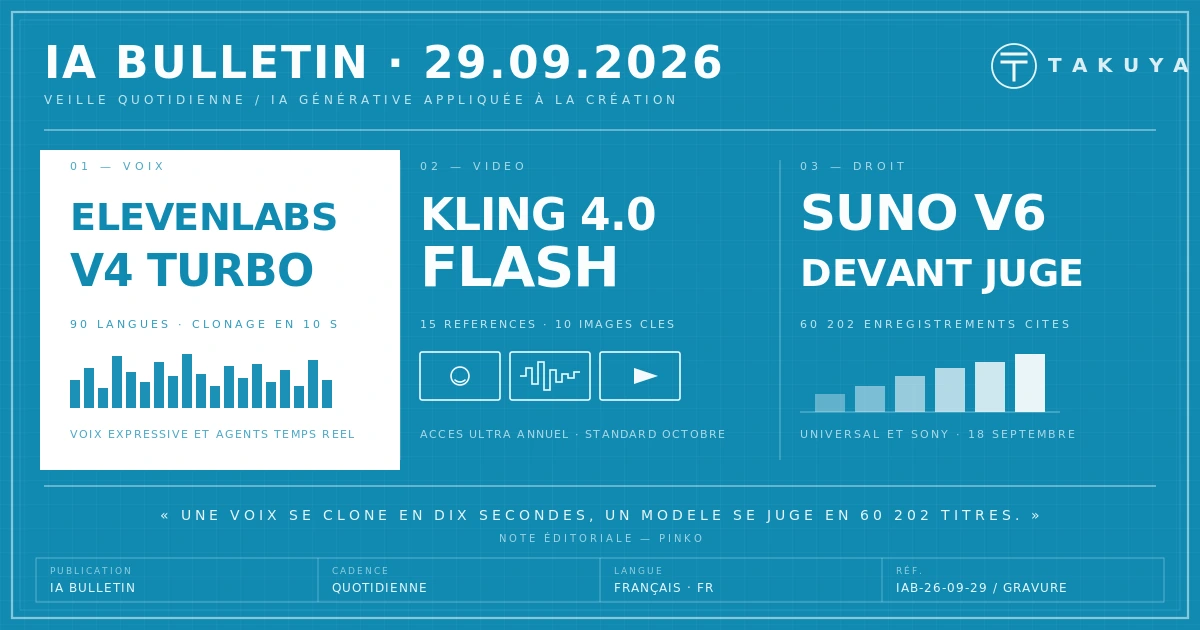
ElevenLabs a lancé le 28 septembre Eleven v4 et Eleven v4 Turbo, deux modèles de synthèse vocale qui succèdent à la version 3 et couvrent désormais plus de 90 langues, contre 70 auparavant. Le gain de qualité le plus net concerne le japonais, le portugais brésilien, le mandarin et le cantonais, selon l'entreprise. Le contrôle de l'expression passe par des balises intégrées au texte, que l'on peut empiler et enchaîner, tandis que l'identité de la voix reste plus stable sur les passages longs. Le clonage d'une voix ne demande plus que dix secondes d'audio. La variante Turbo, à latence réduite, vise les agents vocaux : elle commence à produire du son dès que le modèle de langage amorce sa réponse.
Dix secondes d'enregistrement suffisent désormais à emprunter un timbre, alors qu'il en faut souvent vingt ans pour en construire un — l'affaire Tsuda de la veille en a donné la mesure. La progression annoncée sur le japonais, le mandarin et le cantonais déplace aussi la question : les voix les plus exposées ne sont plus seulement anglophones.
Les balises d'expression, empilables et enchaînables, ressemblent à une direction d'acteur écrite. Encore faut-il savoir ce que l'on veut entendre : une voix dirigée sans vision reste une voix moyenne, très bien articulée, ce que la statistique esthétique produit de mieux.