IA Bulletin — 12 août 2026

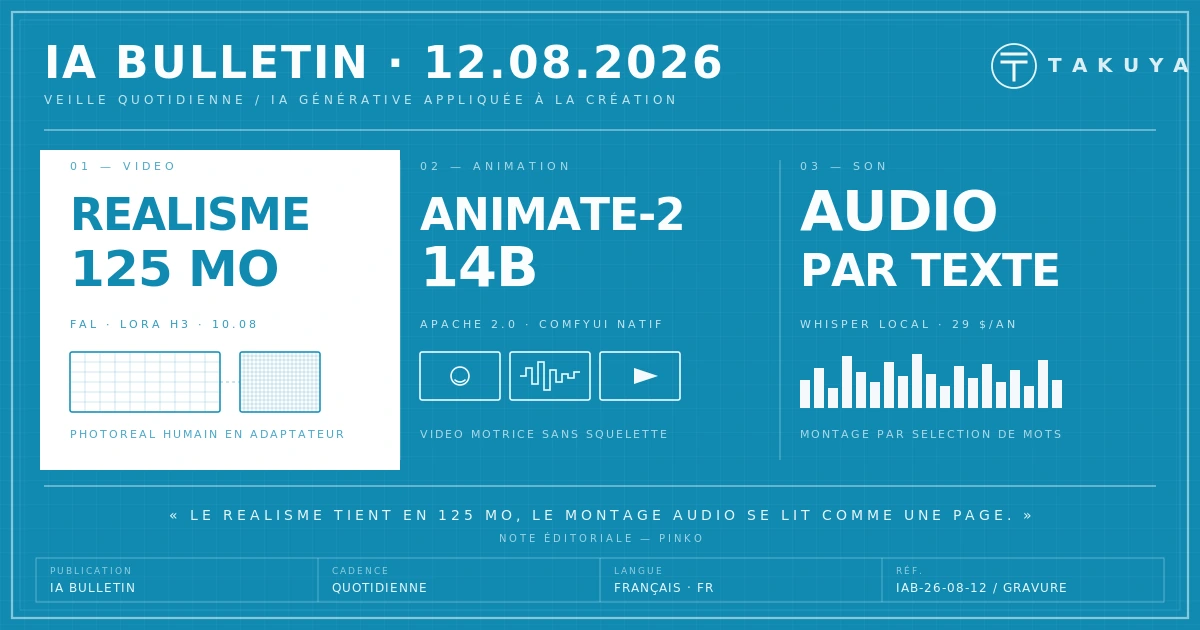
Le photoréalisme humain en 125 mégaoctets /
L'animation de personnage sans squelette /
Le montage audio par le texte

Le photoréalisme humain en 125 mégaoctets

fal a publié le 10 août le Realism People LoRA pour MiniMax H3, un adaptateur en poids ouverts spécialisé dans les personnes photoréalistes, contenu tout entier dans un fichier de 125 mégaoctets. Activé par le mot déclencheur r34l1sm, il couvre en un seul fichier la génération texte-vers-vidéo, image-vers-vidéo et référence-vers-vidéo, tout en conservant l'audio synchronisé natif du modèle. La promesse : des visages qui tiennent le gros plan, un grain de peau réel au lieu du lissage habituel, des micro-expressions cohérentes et une lumière de cinéma — la matière première de la photographie d'une pochette d'album comme du clip. La carte de modèle appuie ses affirmations sur 19 paires avant/après générées à prompt et graine strictement identiques, seule la présence du LoRA variant d'un côté à l'autre. Dans ComfyUI, aucun nœud personnalisé n'est requis : un chargeur LoRA standard, une force de 1.0 — ou 0,6 à 0,8 pour une touche plus légère — et l'adaptateur est aussi servi via l'endpoint API de fal.

Note éditoriale

Le photoréalisme cesse d'être une propriété du modèle pour devenir un curseur qu'on lui visse dessus — 125 mégaoctets décident si une peau respire ou brille comme du plastique. La méthode des 19 paires à graine constante mérite d'être saluée : c'est un protocole de comparaison honnête, chose rare dans un domaine où la démonstration triée sur le volet fait loi. Reste la question que le fichier ne règle pas : un visage crédible n'est pas encore un visage juste. Le vraisemblable se télécharge désormais ; le regard qui choisit ce que ce visage raconte, non.
Sources : ComfyUI Wiki — fal MiniMax H3 Realism People LoRA — Hugging Face — fal/MiniMax-H3-Realism-People-LoRA

L'animation de personnage sans squelette

Alibaba Tongyi Lab a publié Wan-Animate-2, un cadre d'animation de personnage de bout en bout dont les poids de 14 milliards de paramètres, les scripts d'inférence et l'article scientifique sont ouverts sous licence Apache 2.0. La rupture technique : la vidéo motrice entre directement dans un Diffusion Transformer repensé, supprimant les extracteurs intermédiaires de squelette et d'expression qui causaient dérives d'identité et erreurs de mouvement. Le point de vue de la caméra se découple de la vidéo source et se pilote par le texte — plusieurs angles d'une même animation, identité constante — tandis que le mode multi-personnages transfère un ou plusieurs mouvements vers un ou plusieurs sujets en une passe. Une variante Lite atteint le seuil du temps réel pour l'animation en flux continu, visant avatars numériques et présentateurs de direct. ComfyUI intègre le tout nativement : deux nœuds dédiés, dont un cache qui divise le temps de génération par deux, et des poids reconditionnés prêts à charger — l'atelier local complet, du glisser-déposer à la vidéo finale.

Note éditoriale

La disparition du squelette intermédiaire est plus qu'un détail d'architecture : chaque étape d'extraction était une couche d'interprétation où le geste se déformait en chemin. Le mouvement passe désormais de corps à corps, sans traducteur. Et le cadrage qui se décide par une phrase déplace la fonction même du réalisateur — l'angle de caméra devient une ligne de prompt, réécrite en trois mots. L'outil est là, ouvert, gratuit, local ; la chorégraphie et le découpage, eux, restent un métier.

Sources : ComfyUI Wiki — Wan-Animate-2: End-to-End Character Animation — GitHub — Wan-Video/Wan-Animate-2

Le montage audio par le texte

Vocal Slice, application de bureau lancée le 10 août par le développeur indépendant Wesley Scott, découpe un enregistrement audio en sélectionnant des mots dans sa transcription. Whisper tourne entièrement en local — accéléré par WebGPU avec repli processeur — et produit des horodatages au mot près, si bien que texte et forme d'onde restent verrouillés l'un à l'autre pendant toute la session. Rien n'est téléversé, aucun compte n'est requis : après le téléchargement initial du modèle, l'outil fonctionne hors ligne, argument décisif pour les entretiens confidentiels, les pistes non publiées ou tout ce qui vit sous NDA. Les exports WAV sont sans perte à l'octet près — l'application tranche les échantillons d'origine au lieu de réencoder — et des gabarits de nommage sortent des dizaines de segments aux noms cohérents en une passe. Là où les suites de montage par transcription facturent des abonnements mensuels et des minutes de cloud, la licence coûte 29 dollars par an pour trois machines, Windows et macOS.

Note éditoriale

Lire un entretien de deux heures comme un article et surligner les dix phrases qui comptent : le montage audio rejoint le geste le plus ancien du métier d'éditeur, le crayon dans la marge. La sobriété de l'objet fait sa valeur — pas de multipiste, pas de clonage de voix, une seule tâche exécutée proprement et en local. Face aux suites cloud qui empilent les fonctions et les compteurs, ce genre d'outil à 29 dollars rappelle une économie artisanale du logiciel qu'on croyait éteinte. La confidentialité y est structurelle, pas contractuelle — la nuance vaut cher en studio.

Sources : Creative AI News — Vocal Slice: On-Device Text-Based Audio Editing — Vocal Slice — site officiel
Recherche — Studio Takuya